智能座舱 Agent 的节点监控与时间线回放
从联调时“AI 到底有没有真正调接口”的疑问出发,记录如何用轻量有序事件流实现节点实时监控与纯前端时间线回放,以及多轮循环标识配对、SSE 竞态和线程额度排障经验。
在上一篇把智能座舱的工作流编排跑通之后,内部演示和联调时很快遇到了一个很现实的问题:
当页面最后算出“可退金额 599 元”时,在场的同事和业务方第一反应往往带着疑问:
- “这结果是大模型自己编出来的,还是真去查了订单中心?”
- “第二轮为什么突然换了个工具?”
- “刚才多 Agent 协作里,那三个专家各自拿到了什么数据?”
作为后端开发,当然可以切到终端里 tail -f 翻日志。但一边讲解一边在终端和浏览器之间来回切换,不仅容易把大家的注意力打断,自己排查问题的效率也很低。
于是,在把工作流从 agentDemo 合入智能座舱(enterprise-ai-cockpit 仓库)时,我顺手补上了一套结构化的执行记录与回放机制:页面上既能实时看到节点高亮流转,运行结束后还能拖动时间线游标,随时停在任意一步查看当时的输入和输出。
监控、回放与人工恢复的边界划分
很多人一听到“节点监控与回放”,直觉上会觉得实现起来很重:是不是要在后端搭一套分布式链路追踪,再在前端写复杂的状态机倒带?
其实拆开来看,整套机制的底座非常轻巧,核心只是一份按时间顺序追加记录的执行事件列表。
在动手编码前,最关键的一步是把三个容易混淆的操作在概念上划分清楚:
| 操作模式 | 实际改变了什么 | 是否推进后端业务执行 |
|---|---|---|
| 实时监控 | 接收后端 SSE 推送的新事件,实时更新前端视图 | 是。后端 Graph 正在实际运行,前端作为旁路观察者 |
| 时间线回放 | 仅移动前端事件数组的截断游标(cursor) | 否。 只读取已有记录,不会再次调用大模型、HTTP 接口或 MCP 服务 |
| 人工接管恢复 | 提交人工审核意见,驱动后端运行恢复流程 | 是。会唤醒挂起的任务,继续产生新的业务节点与事件 |
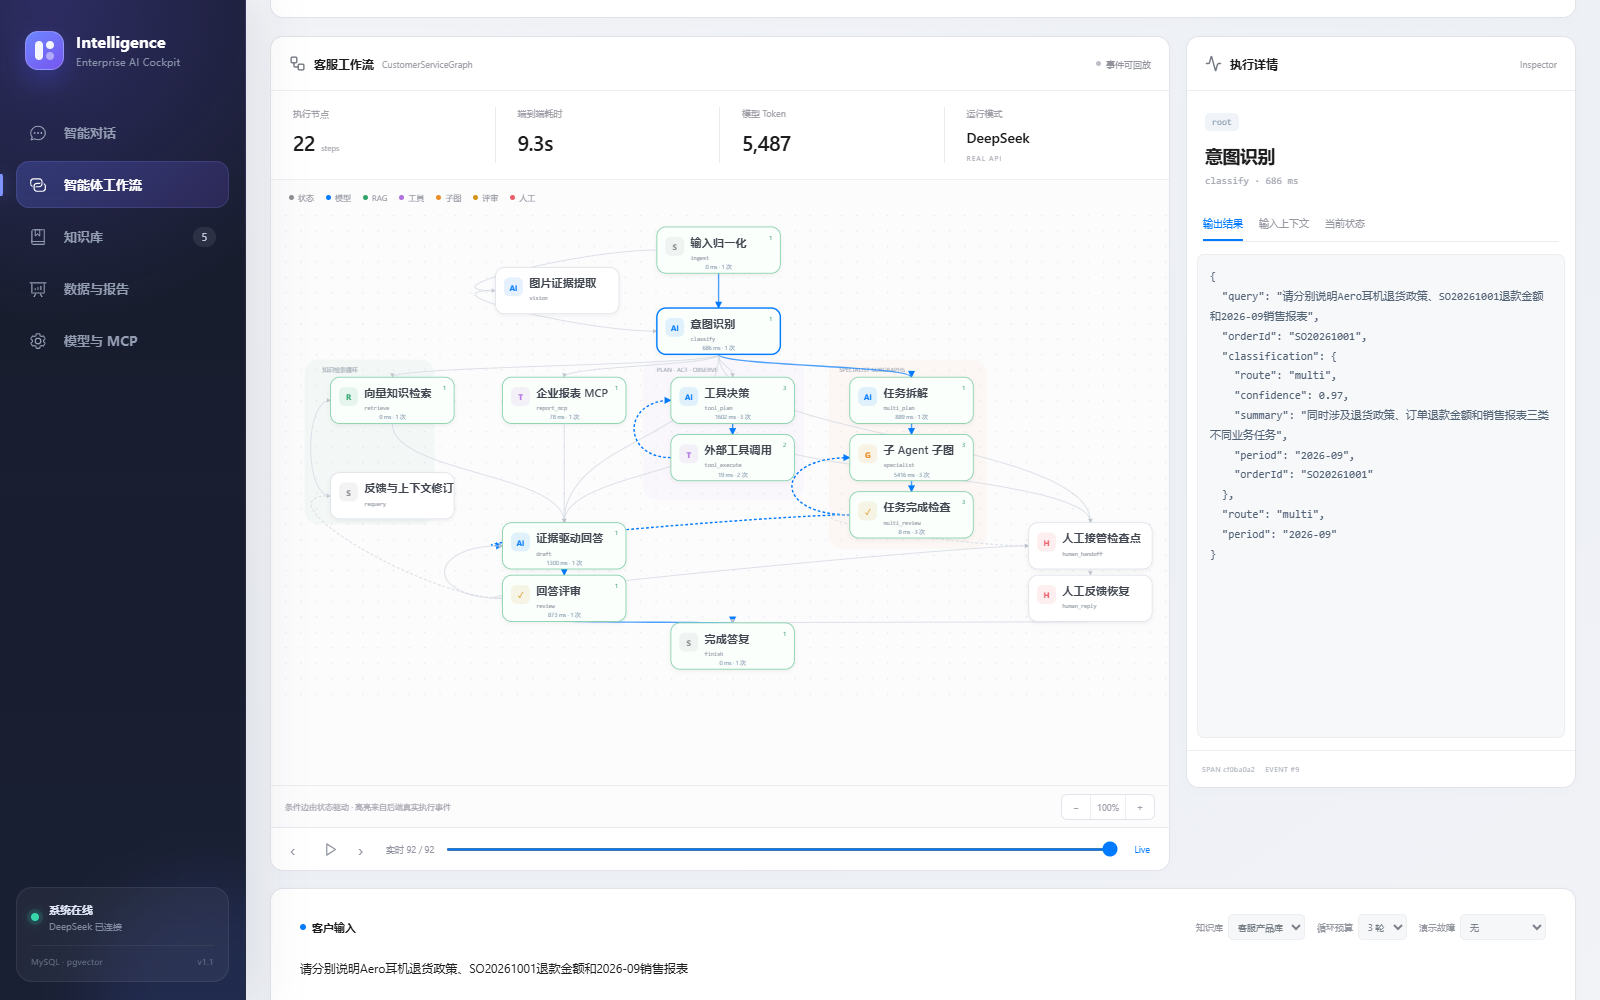
把这个边界理顺后,界面交互就不会让人产生误解:
- 页面上的**“暂停回放”**,只是清除了前端播放器的定时器,后端正在跑的任务不会因此停下;
- 想要真正中止任务,需要点击**“停止当前工作流”**,由前端向后端显式发送取消请求;
- 反复点开历史节点查看输入输出是完全安全的,因为回放只是在浏览前端缓存的历史快照,并不是把业务状态倒回去重新执行一遍(Time-travel execution)。
在八个真实场景中核验执行链路
为了避免监控退化成“只看节点变不变绿的表面动画”,我直接用工作台里的八个业务场景做端到端验收,在同一份记录里核对实际发生过的数据链路:
| 业务场景 | 在记录中核验的关键执行证据 |
|---|---|
| 产品知识 RAG | retrieve 节点返回的知识来源切片、相似度分数,以及生成草稿实际引用的证据 |
| 图片与文字理解 | vision 视觉节点提取出的故障码(如 E02)是否进入了下一步意图分类与检索上下文 |
| 企业报表 MCP | 看到 report_mcp 实际调用返回的报表数据,而不是模型在文本里自行猜测的数字 |
| 工具调用循环 | 每一轮 tool_execute 的具体工具名、输入参数、执行耗时与各自独立的 Span |
| 多 Agent 协作 | 知识、报表、订单三个专家的独立子图路径、父子 Span 嵌套关系,以及汇总节点收拢的证据 |
| 人工接管与恢复 | 任务挂起时的 run.waiting 事件、保存的交接资料,以及提交人工意见后派发的 run.resumed 和 human_reply |
| 反馈驱动重检索 | 首次召回不足时,两次 retrieve 之间确实插入了 requery 改写节点,且查询词发生了变化 |
| 工具异常与预算 | 工具抛出超时异常时,失败记录作为 Observation 写入状态;预算耗尽后流向人工兜底出口 |
后端统一包装器与多层次事件标识
不在每个业务函数里手写埋点
给状态图加监控时,如果在每个业务节点方法里手动写 log.info 或发事件,代码很快就会变得臃肿,而且一旦节点抛出未捕获异常,结束事件很容易漏掉。
我们的做法是在 WorkflowEngine 注册节点时,通过高阶函数 wrapped 对所有业务节点做统一包装:
// 统一包装业务节点,无侵入注入事件记录能力
graph.addNode("tool_plan", wrapped("tool_plan", this::toolPlan));
graph.addNode("tool_execute", wrapped("tool_execute", this::toolExecute));
包装器内部的逻辑很直接:
public <T> NodeAction<T> wrapped(String nodeId, NodeAction<T> businessStep) {
    return state -> {
        String spanId = UUID.randomUUID().toString();
        long startNs = System.nanoTime();

        // 1. 记录边经过与节点开始事件
        emit("edge.traversed", Map.of("from", state.getLastNode(), "to", nodeId));
        emit("node.started", nodeId, spanId, state.getPublicSnapshot());

        try {
            // 2. 执行实际的业务纯函数
            Map<String, Object> delta = businessStep.apply(state);
            long durationMs = (System.nanoTime() - startNs) / 1_000_000;

            // 3. 记录节点完成及本次产生的状态增量(Delta)
            emit("node.completed", nodeId, spanId, delta, durationMs);
            return delta;
        } catch (Exception e) {
            long durationMs = (System.nanoTime() - startNs) / 1_000_000;
            // 4. 捕获并记录失败事件,原样向上抛出异常
            emit("node.failed", nodeId, spanId, sanitizeError(e), durationMs);
            throw e;
        }
    };
}
这里有一个很关键的细节:node.completed 记录的只是当前节点返回的增量(Delta),而不是整个 State 的全量快照。如果把增量误当成全量状态,前端展示时就会以为其他未修改的字段丢失了;全量状态交由 Graph 底层状态机统一合并。
循环与子图场景下为什么不能只靠 nodeId
在简单的线性流程里,用 nodeId(比如 tool_execute)标识一步操作没有问题。但一旦进入工具循环(Loop)和多专家子图,单靠 nodeId 就会对不上号:
比如在退款流程中,tool_execute 在第一轮查订单时执行了一次,第二轮算金额时又执行了一次;甚至在订单专家子图内部,也使用了相同的节点名。如果前端只按 nodeId 去配对“开始事件”和“完成事件”,很容易把第一轮的输入错配给第二轮的输出。
为此,我们在事件模型里设计了六个层级的标识字段:
| 字段名称 | 作用与含义 |
|---|---|
| traceId | 整场运行的唯一 ID,本项目中与该次 Run ID 一致 |
| nodeId | 业务节点名称,代表逻辑定义(如 tool_execute) |
| spanId | 单次具体执行的唯一实例标识。同一节点循环执行 5 次,会产生 5 个不同的 spanId |
| parentSpanId | 调用链层级标识,把模型调用或专家子图关联到外层调度节点 |
| path | 图执行路径。主图为 root,专家子图形如 root/toolAgent[3],避免父子图重名混淆 |
| seq | 单次 Run 内单调递增的序号,用于前端断线重连补发与去重 |
前端在组装节点详情时,输入与输出严格按 spanId + path 配对。这样无论工具循环多少轮、专家子图嵌套几层,每次调用的上下文都能准确还原。
实时推送与 SSE 竞态处理
后端在内存的 RunStore 中按序维护事件列表,基于座舱原有的 Spring WebFlux 响应式栈对外暴露 Flux<ServerSentEvent<TraceEvent>>。联调过程中我们处理过两个容易忽略的细节:
1. 订阅时的事件间隙竞态
用户打开页面订阅正在运行的任务时,常规步骤是:先把游标之前的历史事件补发给客户端,再把客户端连接注册到实时监听队列中。但如果把两步拆在锁外写:
// 存在竞态的写法
List<TraceEvent> history = run.getHistoryAfter(lastSeq);
sendHistory(history);
// <-- 如果刚好在这段微小间隙内,有节点执行完并发出了事件...
run.subscribe(clientListener); // 这条新事件既不在 history 里,也没被 listener 收到
一旦漏掉关键的 node.completed 事件,前端对应节点就会一直卡在“运行中”状态。解决办法是在 Run 对象的同一把锁内原子化完成“读取补发历史”与“登记实时监听者”,保证事件序列连续不断层。
2. Nginx 代理缓冲导致的“假实时”
上线联调时还遇到过一个现象:本地直连运行很顺畅,但走线上 Nginx 反向代理后,运行期间页面毫无动静,等后端全部跑完,整条链路才在同一秒突然全部亮起。
原因是 Nginx 默认开启了代理缓冲,把 SSE 的小数据块攒在缓冲区里,直到连接结束才一次性刷出。在响应头里显式加上两行配置即可解决:
X-Accel-Buffering: no
Cache-Control: no-cache
用数组前缀实现前端时间线回放
相比后端的并发控制,前端的时间线回放实现得非常简洁:收到 SSE 数据后,只管把事件按顺序追加进响应式数组 events,界面上的所有渲染状态统一由一个计算属性(computed)派生:
// 实时模式取全量事件,回放模式只截取游标之前的前缀
const visibleEvents = computed(() =>
  trackLive.value ? events.value : events.value.slice(0, cursor.value)
)
图上每个节点的状态(未执行 / 运行中 / 已完成 / 失败)、执行次数、经过的边高亮以及当前轮次的工具卡片,全部由 visibleEvents 纯函数式计算得出。拖动时间线游标本质上只是改变数组切片长度,整张图和详情面板就会自然同步回对应时刻,不需要单独维护一套倒带动画或计时器。
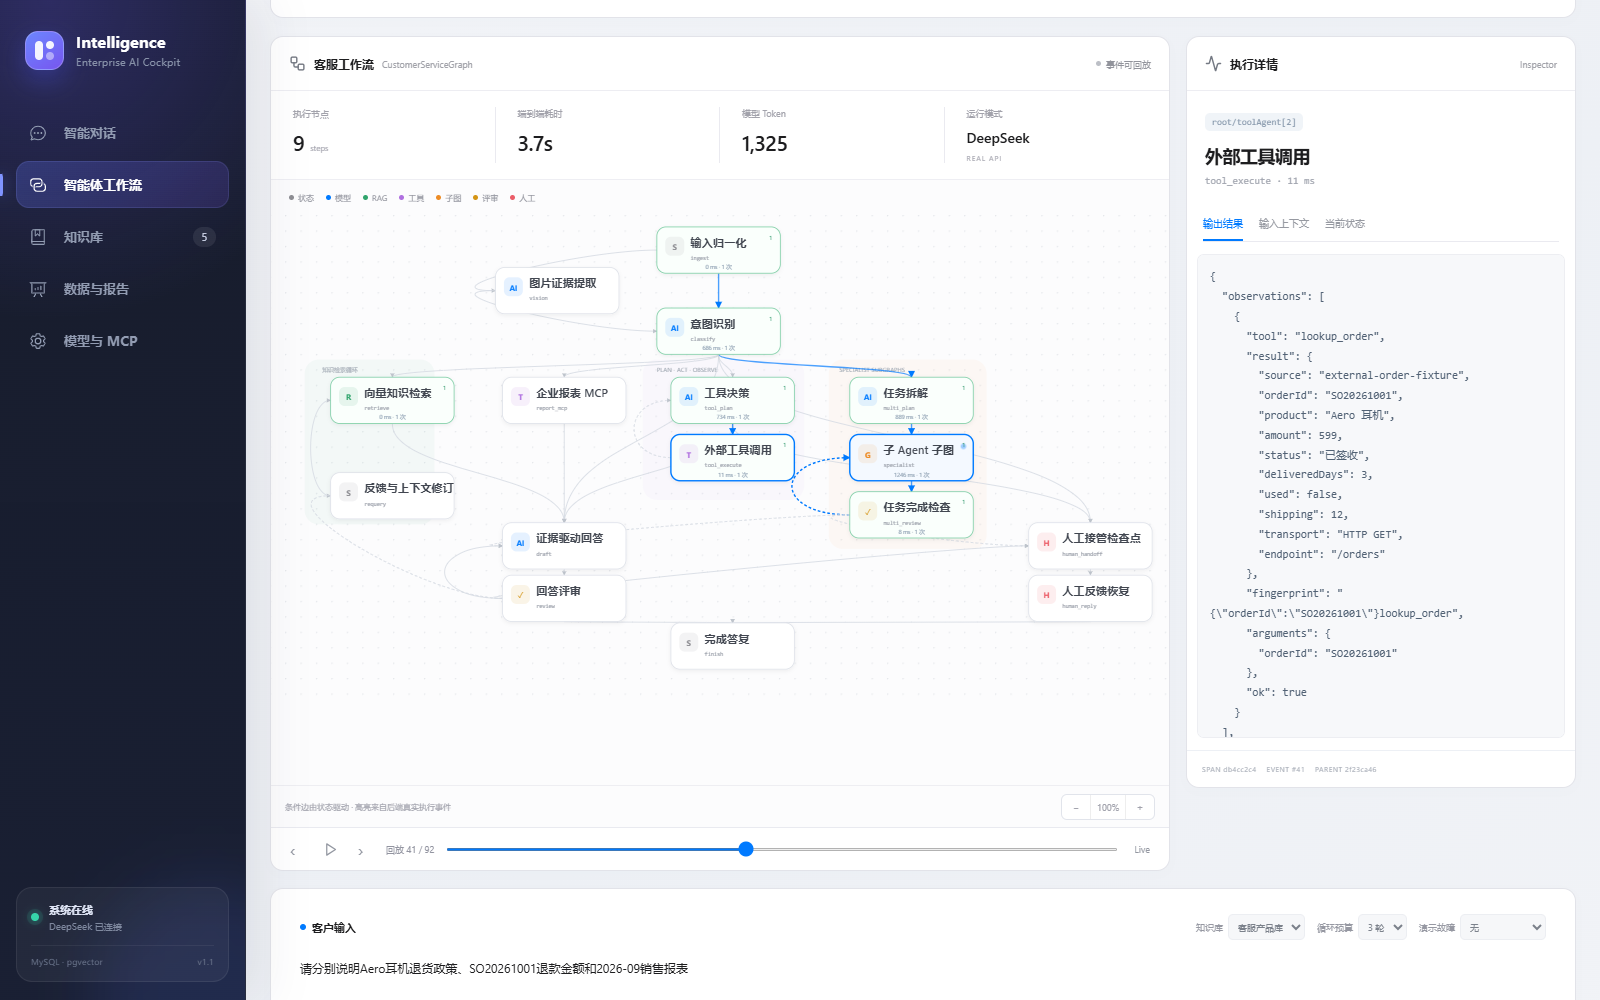
这里有两个实现细节值得留意:
- 游标是数组索引,不是
seq:单个节点运行会产生edge.traversed、node.started、node.completed等多条事件,所以“单步前进”是在数组中跳向下一个node.completed所在的下标,而不是简单地给seq + 1; - 工具失败与节点完成的区别:外部 HTTP 工具超时被业务代码捕获并封装后,返回的是
toolOutcome.ok = false。对 Graph 而言,节点自身已经正常跑完并产出了“一条失败观察记录”,因此节点事件是node.completed,同时工具卡片标红显示失败。只看节点绿没绿,不足以判断外部业务调用是否成功。
一次真实的线程池排障经历
上线前的全量在线回归测试中,我们遇到过一次很典型的偶发中断:工作流已经顺利跑完了第一轮超时重试、订单查询与 599 元退款试算,眼看就要输出最终答复,却在最后的 review 评审节点中断了。
如果还是过去的黑盒调法,第一反应往往是怀疑“模型接口是不是又超时了”或者“退款服务是不是抖动了”。但点开节点监控记录一看,报错信息非常明确: java.lang.OutOfMemoryError: unable to create new native thread。
问题根本不在模型或业务逻辑上——座舱容器里同时跑着 WebFlux 线程、SSE 长连接、HTTP 客户端以及独立子进程 MCP Server,并发叠加触到了容器默认的 90 线程上限。把座舱线程限额上调到 128 后,八个在线场景全部稳定通过。
这也是结构化执行记录的实际价值:它把容易被当成“玄学黑盒”的 AI 执行过程,拉回到了可度量、可定位的常规软件工程排障体系里。
状态持久化与工程收尾
为了让历史记录在生产环境长期可用,我们做了轻量的文件落盘设计:
- 每当主图根节点边界完成、任务结束、异常中断或进入人工等待时,将运行快照写入
shared/workflow/runs目录下的 JSON 文件; - 写入采用“先写临时文件,再原子替换(Atomic Rename)”的方式,防止进程意外退出造成半写损坏;
- 存储目录独立于前端静态包与后端 JAR 发布目录之外,版本升级或重启后,历史运行记录与回放依然可以直接读取。
目前默认保留最近 100 条运行记录,页面历史抽屉展示最近 40 条,落盘前统一剥离敏感凭据与原始图片二进制流。
从最初为了技术分享编写 agentDemo,到把整套工作流与监控回放合入智能座舱,最大的感触是:AI 智能体的工程重心,正在从单纯的提示词调优,转向后端有状态编排与前端可观测性建设。
可以直接在智能座舱工作流页面拖动时间线体验回放效果,整体状态图编排设计见上一篇工作流编排记录。