AI 量化系统的工程闭环与可信研究
从数据采集、任务调度、因子计算到回测验证与学习记录,构建一套具备状态机持久化、数据版本化与可追溯审计能力的量化研究系统。
在搭建量化系统时,直观上最容易被关注的是回测净值曲线与年化收益指标。但在实际工程落地中,决定系统是否可信的关键在于更基础的数据与执行链条:数据采集时点是否具备确定性、异常任务能否安全重试、模型决策是否具备追溯依据、回测计算是否存在未来函数。
为了解决这些核心工程问题,本项目并未设计为一个单向的选股工具,而是按照可复核、可复现的研究闭环进行构建。无论是数据变更还是执行异常,系统都能提供完整的状态流转与数据记录。
完整的研究闭环架构
前端基于 Vue 3 + Vite 构建,负责呈现行情看板、股票池、因子排行、舆情事件、策略回测、Walk-forward 分析、任务状态监控以及量化实验课程。后端采用 FastAPI 提供清晰的 RESTful 接口;耗时较长的数据采集、大模型推理与回测计算交由独立的 Worker 进程异步执行;MySQL 负责持久化存储业务实体、任务状态机、数据版本与学习进度。
一个典型研究任务的生命周期包含以下阶段:
- 前端提交研究参数,API 创建任务记录并写入初始状态
queued; - 独立 Worker 认领任务,将状态原子更新为
running; - 执行数据抓取、新闻情绪抽取或多因子回测,并逐步更新执行进度;
- 任务执行成功后保存结构化指标;若发生异常则记录具体错误堆栈,支持手动重试;
- 服务重启或前端刷新后,依托数据库持久化,任务状态依然完整保留。
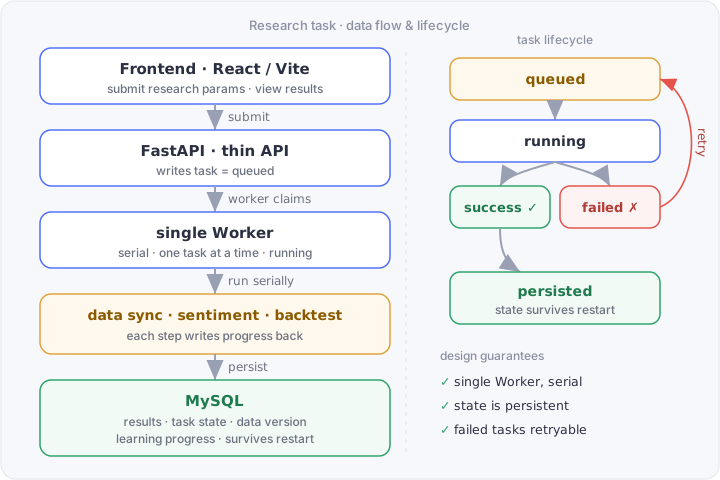
在资源受限的环境(例如 2 核 2GB 内存配置)下,系统采用单 Worker 串行执行模式。这种设计避免了行情拉取、LLM 网络请求与 pandas 矩阵计算并发时引发的内存瞬时峰值,同时也降低了故障排查的定位成本。
状态机与持久化机制
将计算任务抽象为具备完整生命周期的状态机对象,是系统稳定性的核心基础。每次状态迁移均对应明确的数据库操作:提交阶段标记为 queued,认领阶段标记为 running,终止阶段标记为 success 或 failed。
这种基于数据库的状态持久化带来了明显的容灾优势:Worker 进程异常终止、服务器重启或运维中断都不会造成任务状态丢失。系统重新启动后,处于 running 状态且无存活进程对应的任务会被识别为中断任务,并可重新进入队列排队;已完成的 success 与 failed 记录保持不变。
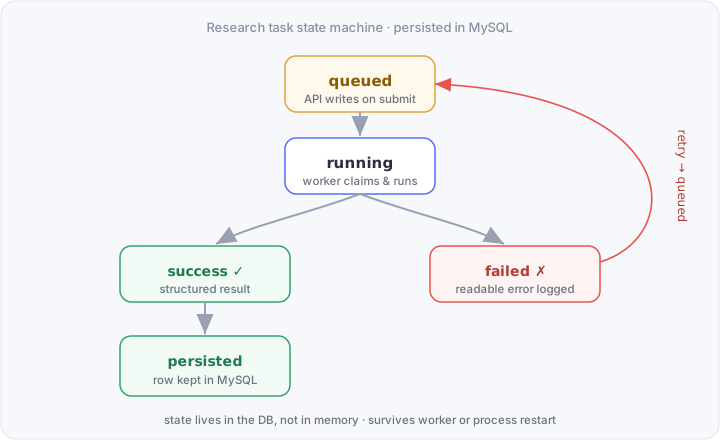
针对失败处理,系统在状态变更为 failed 的同时,会持久化记录具体的失败原因(如上游数据源超时、标的停牌导致数据缺失、时间区间异常等),便于后续排查。
重试逻辑必须满足幂等性要求。重新执行任务时,系统会先清理上一次执行生成的派生数据与中间结果,然后再启动计算流程;基础行情与原始数据则采用按需增量补齐策略,避免重复覆盖。状态流转逻辑示例如下:
# 任务状态迁移逻辑示例
def run_task(task):
    task.mark("running")            # 认领任务并落库
    try:
        clean_previous_outputs(task)  # 清理历史派生结果,保证幂等
        result = execute(task)        # 执行采集 / 情绪抽取 / 回测
        task.save(result)             # 结构化指标落库
        task.mark("success")
    except Exception as e:
        task.mark("failed", error=readable(e))  # 记录格式化错误信息
数据版本管理与可复现性
如果系统仅存储最新快照,历史回测将无法实现精确复现。为此,系统为采集数据引入了批次与版本标识:每次数据同步均作为独立的采集批次存储,回测引擎根据指定的历史版本进行数据绑定。
数据版本化机制确保了策略研究的基石稳固。当需要对比不同时间点或不同数据源的策略表现时,历史批次数据可以被直接索引与复用,从而保证了实验结果的可复现性。
大模型结构化抽取与职责隔离
系统将大模型定位于文本信息的结构化处理层:针对新闻与公告,模型输出利好、中性或利空的情绪标签,并提供标准化得分、置信度、核心摘要及判断依据。输出结果附带模型名称与分析时间戳进行存储,同时保留完整的原始文本。
每条抽取结果均包含完整的上下文字段,结构示例如下:
{
  "label": "bullish",
  "score": 0.62,
  "confidence": 0.71,
  "summary": "季度营收指引上调",
  "reason": "公告提到下季度出货预期高于市场共识",
  "model": "llm-extractor",
  "analyzed_at": "2026-05-11T09:20:00Z"
}
在系统设计中,严格遵守“原始数据不可变,派生数据可重算”的原则。原始文本作为事实依据入库后不作修改;情绪标签与分值属于派生特征,当提示词更新或更换底层模型时,可针对同一批原始语料重新运行抽取流程,生成新的特征版本。
这种职责划分明确界定了各模块的边界:
- 大模型专注于非结构化文本的语义理解与倾向抽取;
- 仓位管理与交易规则完全由确定性的因子计算和回测逻辑执行。
确定性代码保证了在相同输入下产生完全一致的计算结果,避免了不确定性向交易决策层扩散,使策略表现与归因分析具备严谨的审计基础。
阶梯式实验课程与系统集成
系统内置了十一章循序渐进的量化课程与交互式实验,内容涵盖 K 线基础、Python/pandas 时间序列处理、可信回测原则、舆情因子构建、Walk-forward 验证方法以及量化工程化架构。学习进度默认缓存在前端本地,并在后端连通时同步持久化至 MySQL。
课程体系采用自底向上的设计逻辑:先掌握基础数据处理与因果时序规则(避免未来函数与幸存者偏差),进而学习文本因子的构建与验证,最后进入工程化架构与样本外检验。
系统定位与实盘边界
本项目专注于量化策略的研究与教学实验,不包含券商实盘交易接口。真实交易环境涉及停牌撮合限制、涨跌停流动性断裂、大单冲击成本、滑点模型、行情断线恢复等复杂的交易链路问题。在完善上述实盘基础设施之前,系统严格保持在回测研究与仿真验证的定位上。
可以在 /quant/ 访问当前运行的研究平台。
本项目与文章内容仅供技术研究与学习交流,不构成任何投资建议。