企业智能座舱的 RAG、向量检索与流式回答
解析企业级智能座舱在异构存储解耦、pgvector 向量检索与关键词降级、真实 SSE 事件流转发及低资源环境下的工程实践。
将 RAG(检索增强生成)技术从原型验证推进到企业级智能座舱,系统面临的挑战远不止前端对话框的交互。在生产落地过程中,必须系统性解决文档元数据与向量索引的持久化同步、文档删除时的跨存储清理、检索分块精准溯源、大模型端到端真实流式推送,以及统一的权限与资源隔离等工程问题。
本项目旨在构建一个具备高可用降级与资源边界约束的企业级 AI 座舱系统,将文档摄取、向量检索、事件流式推送和异常治理等关键链路透明化实现。
2026-08 更新: 本文记录了系统初期“向量优先、关键词降级”的架构设计;当前线上版本已进一步演进为结构感知分块、Dense + Keyword 双路召回、RRF 倒数排名融合、时效过滤与相邻分块动态合并。详细调优方案可参考《企业 RAG 知识工程与可调优座舱实践》。
异构存储分层架构与职责划分
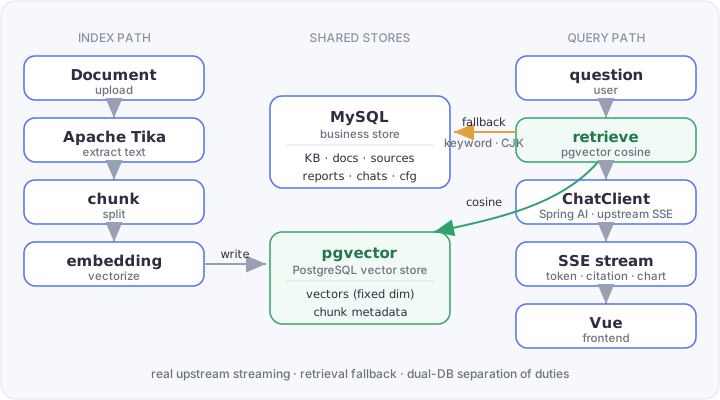
系统在持久化层采用 MySQL 与 PostgreSQL(集成 pgvector 扩展)的双库架构:
- MySQL:存储知识库配置、文档元数据、外部数据源连接、分析报告模板、任务运行流水、多轮对话上下文及权限规则等结构化业务数据。
- PostgreSQL + pgvector:负责存储文档切分后的高维嵌入向量(Embedding Vectors)以及对应的切片元数据(Chunk Metadata)。
关系型业务数据依赖严格的 ACID 事务、外键约束、多维过滤与分页查询;而语义向量检索的核心计算是基于高维空间距离(如 Cosine 相似度)的 top-k 近似最近邻(ANN)搜索。将两类数据解耦至对应特性的数据库引擎中,能够保证读写路径的性能与架构清晰度。
文档解析与向量构建流程如下:
- 格式提取:通过 Apache Tika 解析 PDF、Word、Markdown 及纯文本文件,提取无格式纯文本;
- 文本分块:按固定窗口进行切分(如 500 字符/块,重叠 50 字符),滑动重叠窗口用于保留跨切片边界的上下文语义;
- 向量生成:调用 Embedding 模型生成固定维度的向量表示;
- 双库写入:将向量与切片元数据(文档 ID、分块序号、字符偏移区间)写入 pgvector,同时在 MySQL 中持久化文档主体元数据与处理状态。
处理流程如下所示:
# 索引摄取链路(Index Pipeline)
raw_text = tika.extract(file)
chunks   = split(raw_text, size=500, overlap=50)
for chunk in chunks:
    vector = embed(chunk.text)
    pgvector.insert(vector, metadata={doc_id, chunk_index, span})
mysql.save(doc_metadata)
切片元数据(Chunk Metadata)是实现精准溯源的关键:检索阶段通过向量距离命中 top-k 切片后,系统依托元数据反查对应的文档标题与段落位置,为前端生成可核对的引用链接。
检索执行时,系统首选 pgvector 进行 Cosine 相似度检索,取回相似度最高的前 k 个文本切片作为提示词上下文:
# 检索查询链路(Query Pipeline)
query_vector = embed(user_question)
hits = pgvector.search(query_vector, top_k=5)
if vector_unavailable or len(hits) == 0:
    hits = mysql.keyword_cjk_search(user_question)  # 关键词与 CJK 降级检索
context = [hit.chunk for hit in hits]
为提升检索可用性,系统设计了完备的降级机制:当 pgvector 向量服务发生网络中断、响应超时或维度异常时,检索链路自动降级至 MySQL 的 CJK 全文与关键词匹配。虽然关键词检索在泛化语义匹配上弱于向量检索,但有效避免了因单一组件故障导致整个问答链路不可用的情况。
| 维度 | MySQL | PostgreSQL + pgvector |
|---|---|---|
| 存储实体 | 知识库、文档元数据、数据源、报告模板、运行流水、对话上下文 | 固定维度向量、分块元数据(Chunk Metadata) |
| 访问模式 | ACID 事务、条件过滤、外键关联、结构化分页 | Top-k 近似最近邻(ANN)向量检索 |
| 核心职责 | 支撑业务工作流与状态流转 | 支撑语义召回与相似度计算 |
| 问答检索角色 | 关键词 / CJK 降级兜底检索 | 首选 Cosine 向量相似度检索 |
针对文档删除场景,系统先在 MySQL 中将文档状态置为已删除,随后异步触发 pgvector 关联向量切片的清理任务,并辅以周期性对账机制扫描并清理孤儿向量分块。
端到端真实 SSE 流式传输
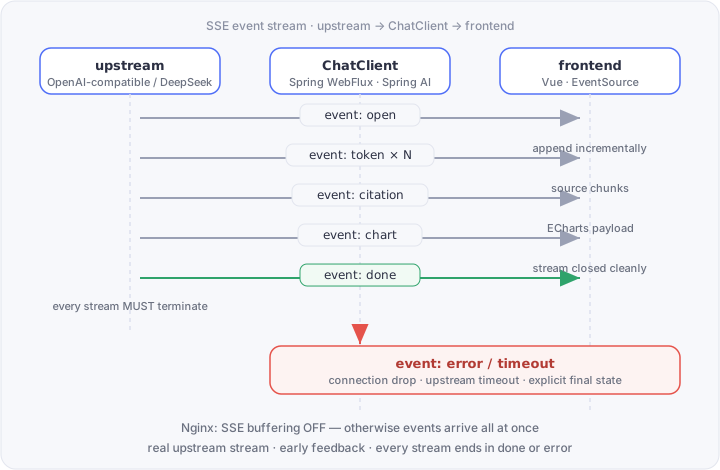
后端基于 Spring WebFlux 响应式技术栈与 Spring AI 构建。ChatClient 消费上游大模型(兼容 OpenAI / DeepSeek 协议)的 Server-Sent Events(SSE)流,并实时向前端 Vue 应用推送事件流。
与本地缓冲完整响应后再模拟打字机效果不同,端到端真实流式能够在上游模型吐出首批 Token 时立即完成首字渲染,显著缩短用户感知的首字延迟(TTFT)。
在事件协议设计中,系统将流式过程显式划分为标准事件:
event: open           // 建立连接
event: token   × N    // 增量文本流,前端逐字追加
event: citation       // 命中的知识库引用源信息
event: chart          // 结构化图表数据(供 ECharts 渲染)
event: done           // 正常生成完毕
event: error/timeout  // 异常或超时终态事件
基于 WebFlux 的 Flux 响应式流天生支持背压控制,避免在服务端内存中缓存大容量文本。同时,后端对每个 SSE 连接均保证以 done 或 error/timeout 作为终态收尾,防止因网络闪断导致前端界面长期悬挂在加载状态。
在反向代理层面,生产环境的 Nginx 针对流式路由显式配置 proxy_buffering off 和 proxy_cache off,避免代理层缓冲区截留事件块,确保流式数据毫秒级直达前端。
前端界面在统一会话流中同步渲染正文文本、来源引用徽标与 ECharts 交互式图表,实现“回答结论 - 证据溯源 - 数据图表”一体化交互。
系统功能边界与安全设计
系统集成了分析报告模板引擎、异步运行流水、外部数据源连通性测试及 MCP 工具扩展等模块。
在安全与功能边界上:
- 受限操作保护:演示环境公开只读功能,上传、删除、敏感报告生成由后端短效操作令牌(Action Token)鉴权保护;
- 真实引用约束:模型生成的结论必须由检索召回的切片提供上下文支持,禁止脱离证据上下文进行无依据推论。
轻量化运行环境的资源治理
在 2GB 内存的低配云服务器上,系统与量化交易和跨境趋势分析服务共存。前端全部预编译为静态资源;后端运行于经过严格参数调优的受限 JVM 实例中。
系统对各类资源设置了刚性上限:
- JVM 堆与元空间:设置
-Xmx与-XX:MaxMetaspaceSize,避免堆内存无序膨胀; - 直接内存(Direct Memory):WebFlux 底层依赖 Netty 进行堆外内存分配,系统显式指定
-XX:MaxDirectMemorySize进行约束; - 连接池与线程池:HikariCP 连接池与 Quartz 调度线程池均配置极简并发配额。
在系统级资源告警时,座舱服务具备最低的运行优先级,可根据运维策略优先降级或暂停,以保障主干服务的资源安全。
可以在 /smartCockpit/ 访问当前部署的企业智能座舱。