大模型舆情因子的 Walk-forward 与样本外检验
探讨将大模型应用于量化舆情特征工程的实践:从非结构化文本的结构化事件抽取、时序对齐与衰减加权,到 Walk-forward 滚动回测与样本外增量检验。
在将大语言模型(LLM)引入量化投研体系时,若直接让大模型输出多空交易指令,往往会面临决策黑盒化、时间边界模糊以及提示词微小变动引发策略不稳定的问题。更重要的是,这种端到端的方式混合了“文本语义理解”与“交易组合决策”两层不同的任务,使得后续的回测归因与风险控制难以进行。
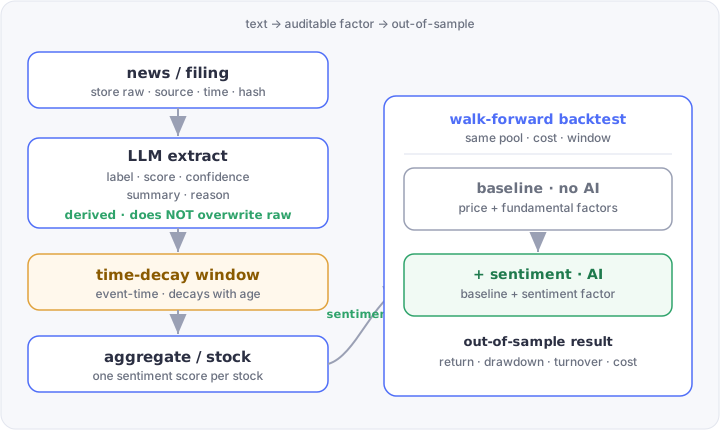
在工程实践中,更稳健的方式是将大模型定位于特征工程中的信息抽取层:利用大模型将非结构化的新闻与研报文本转化为可度量、可复查的结构化事件,再由确定性的多因子模型与风险控制模块完成组合管理,并通过严格的样本外实验检验其增量价值。
文本特征的结构化与审计设计
当原始新闻或公告进入系统后,系统首先记录数据源链接、发布时间戳及原始文本的内容哈希(Content Hash)。大模型对文本进行解析后,输出标准化的结构化字段:
- 情绪标签(Label):利好(bullish)、中性(neutral)或利空(bearish);
- 情绪得分(Score):归一化至
[-1.0, 1.0]区间; - 置信度(Confidence):取值范围
[0.0, 1.0]; - 核心摘要与推理依据(Reason):提取支撑情绪判断的核心事实;
- 模型元数据:记录具体的模型版本标识与推理时间戳。
结构化事件的数据协议如下:
{
  "event_id": "sha1(raw_text)",
  "published_at": "2026-03-11T09:20:00Z",
  "source_url": "https://...",
  "label": "bullish",
  "score": 0.62,
  "confidence": 0.71,
  "summary": "季度营收指引上调",
  "reason": "公告显示下季度出货量预期环比增长20%",
  "model": "llm-vX",
  "analyzed_at": "2026-03-11T09:24:10Z"
}
系统严格遵循“原始数据不可变,派生特征可重算”的数据治理原则。原始语料入库后保持不可篡改;情绪得分与推理理由作为派生特征独立存储。当提示词模板升级或底层模型更迭时,可针对历史语料重新触发批量抽取,生成新的特征版本供回测对照。
时序对齐、事件去重与时间衰减
在舆情因子计算中,时序一致性是防范未来函数的首要前提:
- 发布时点严格对齐:事件进入因子计算的时间戳必须以公开媒体的实际发布时间(
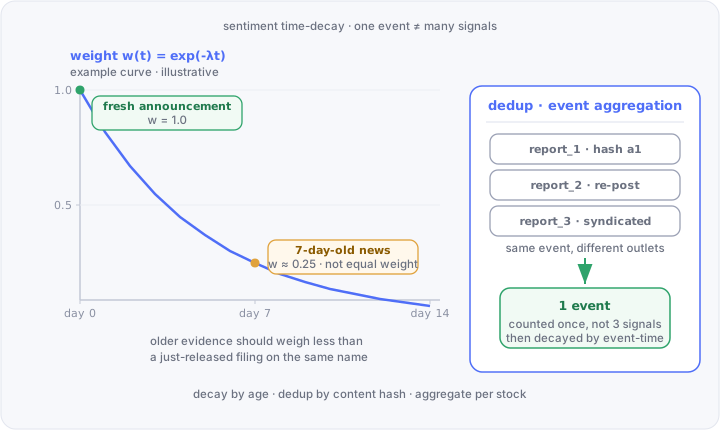
published_at)为准,且该时间戳必须严格早于策略生成调仓决策的时点; - 多源转载去重:同一重大事件常被多家媒体频繁转载,系统通过文本哈希与相似度聚合将重复报道合并为单次事件,防止相同事件在情绪得分聚合时被多次加权而产生虚假的“热度共识”;
- 时间指数衰减:新闻事件对市场的影响力具有明显的时效性。系统采用指数衰减窗口对历史事件进行加权汇总:
w(t) = exp(-λ · Δt)          # Δt = 当前决策时点 − 事件发布时点(单位:天)
Score_stock = Σ_i  w(t_i) · Confidence_i · Score_i
对照实验与增量收益评估
文本分类的高准确率并不等同于交易策略的超额收益。如果相关舆情信息已被市场充分定价,或者因子带来的换手成本超过其阿尔法收益,该因子就缺乏实盘价值。
为此,系统构建了严谨的对照实验框架:在相同股票池、相同交易成本假设与相同回测区间下,对比基准策略(仅包含量价与财务因子)与叠加舆情因子后的策略表现:
| 评估维度 | 基线策略(无 AI 舆情) | 叠加舆情因子策略 | 核心考察指标 |
|---|---|---|---|
| 样本外年化收益 | 基准对照 | 实验组 | 因子是否提供稳定的增量收益 |
| 最大回撤与年化波动率 | 基准对照 | 实验组 | 收益提升是否以过度放大风险为代价 |
| 调仓换手率与交易成本 | 基准对照 | 实验组 | 超额收益能否完全覆盖交易磨损 |
| 分市场周期表现 | 基准对照 | 实验组 | 因子在单边市与震荡市中的表现一致性 |
| 推理延迟与 API 开销 | — | 评估项 | 特征获取的工程成本与实效可行性 |
Walk-forward 滚动回测与样本外检验
为了防止传统静态回测中的过拟合与数据窥探问题,系统采用 Walk-forward(滚动前向) 检验机制:
- 将整个历史时间区间划分为连续重叠的滚动窗口;
- 在每个窗口的**训练集(In-Sample)**上进行因子参数寻优与衰减系数标定;
- 锁定选定参数后,在紧邻其后的**测试集(Out-of-Sample)**上单次运行策略;
- 最终将所有测试集的样本外收益进行无缝拼接,形成整体的 Walk-forward 净值曲线。
窗口 1: [--- 训练集 1 ---][ 测试集 1 ]
窗口 2:        [--- 训练集 2 ---][ 测试集 2 ]
窗口 3:               [--- 训练集 3 ---][ 测试集 3 ]
拼接策略收益:                   [ 测试 1 ][ 测试 2 ][ 测试 3 ]
在 Walk-forward 流程中,测试集数据对策略具有严格的单向封闭性。若某个测试窗口表现不佳,系统将其作为策略适应性指标如实记录,严禁针对特定测试窗口回溯调整超参数,确保实验结论的统计客观性。
总结与工程边界
在量化投研系统中,大模型的核心价值在于将海量非结构化文本高效转化为规范化、可审计的特征输入。投资组合构建与风控纪律依然由确定性的量化模型承载,因子的真实有效性必须经过严格的样本外数据与全链路交易成本检验。
上述因子流水线与 Walk-forward 检验已整合至 AI 量化系统 的投研闭环中。
本文内容仅用于技术研究与量化工程方法探讨,不构成任何投资建议。