スマートコックピット Agent のノード監視とタイムラインリプレイ
「モデルは本当に業務APIを呼んだのか」という結合テスト時の疑問を出発点に、順序付きイベント列によるリアルタイム監視とフロントエンドの前置スライスリプレイ、ループ内のSpan対応付け、SSE購読の競合対策、スレッド上限調査を記録する。
スマートコックピットのワークフローが一通り動くようになったあと、社内デモや結合確認ですぐに現実的な疑問にぶつかった。画面に「返金可能額 599 元」と表示されても、見ている側はそれがどう導かれたのか判断しにくい。本当に注文サービスを照会したのか、2ラウンド目でなぜツールが切り替わったのか、3つの専門家サブグラフはそれぞれどの入力を受け取ったのか。
バックエンドのログを追えば確認はできるが、説明や調査のたびにターミナルとブラウザを行き来すると話が途切れ、切り分けにも時間がかかる。スマートコックピット(enterprise-ai-cockpit リポジトリ)へ統合する際、Graph ワークベンチに構造化された実行記録を追加し、実行中のノード遷移をリアルタイムで見られるだけでなく、終了後に任意のステップで止めて入出力を確認できるようにした。
記録対象はカスタマーサービスのメイングラフ全体であり、デモで重点的に扱うツールループやマルチ Agent 分岐だけではない。RAG、画像読み取り、MCP レポート照会、人手引き継ぎ、2種類のフィードバック再試行がすべて同じノードラッパーを通って同一のイベント列に入るため、「一度で証拠を取得できたケース」と「失敗後にもう一周したケース」を同じ画面で比較できる。
リアルタイム監視・履歴リプレイ・人的復帰を分けて考える
ノード監視とリプレイといっても、大がかりな分散トレーシング基盤や状態マシンの巻き戻しエンジンを作ったわけではなく、核になっているのは時系列順に追記される実行イベント配列だ。
実装に入る前に、混同しやすい3つの操作を明確に分けた。
| 操作モード | 実際に変わるもの | バックエンドの業務実行を進めるか |
|---|---|---|
| リアルタイム監視 | バックエンドが SSE で送る新着イベントを受け取り画面を更新する | 進める。Graph が実行中で、ブラウザは観察のみ行う |
| タイムラインリプレイ | フロントエンドのイベント配列の切り出し位置(cursor)を動かす | 進めない。既存記録を読むだけで、モデルや HTTP / MCP は再呼び出ししない |
| 人的引き継ぎ復帰 | 担当者の確認コメントを送信し、HumanResumeGraph を再開する | 進める。待機中のタスクを再開し、新しいイベントを生成する |
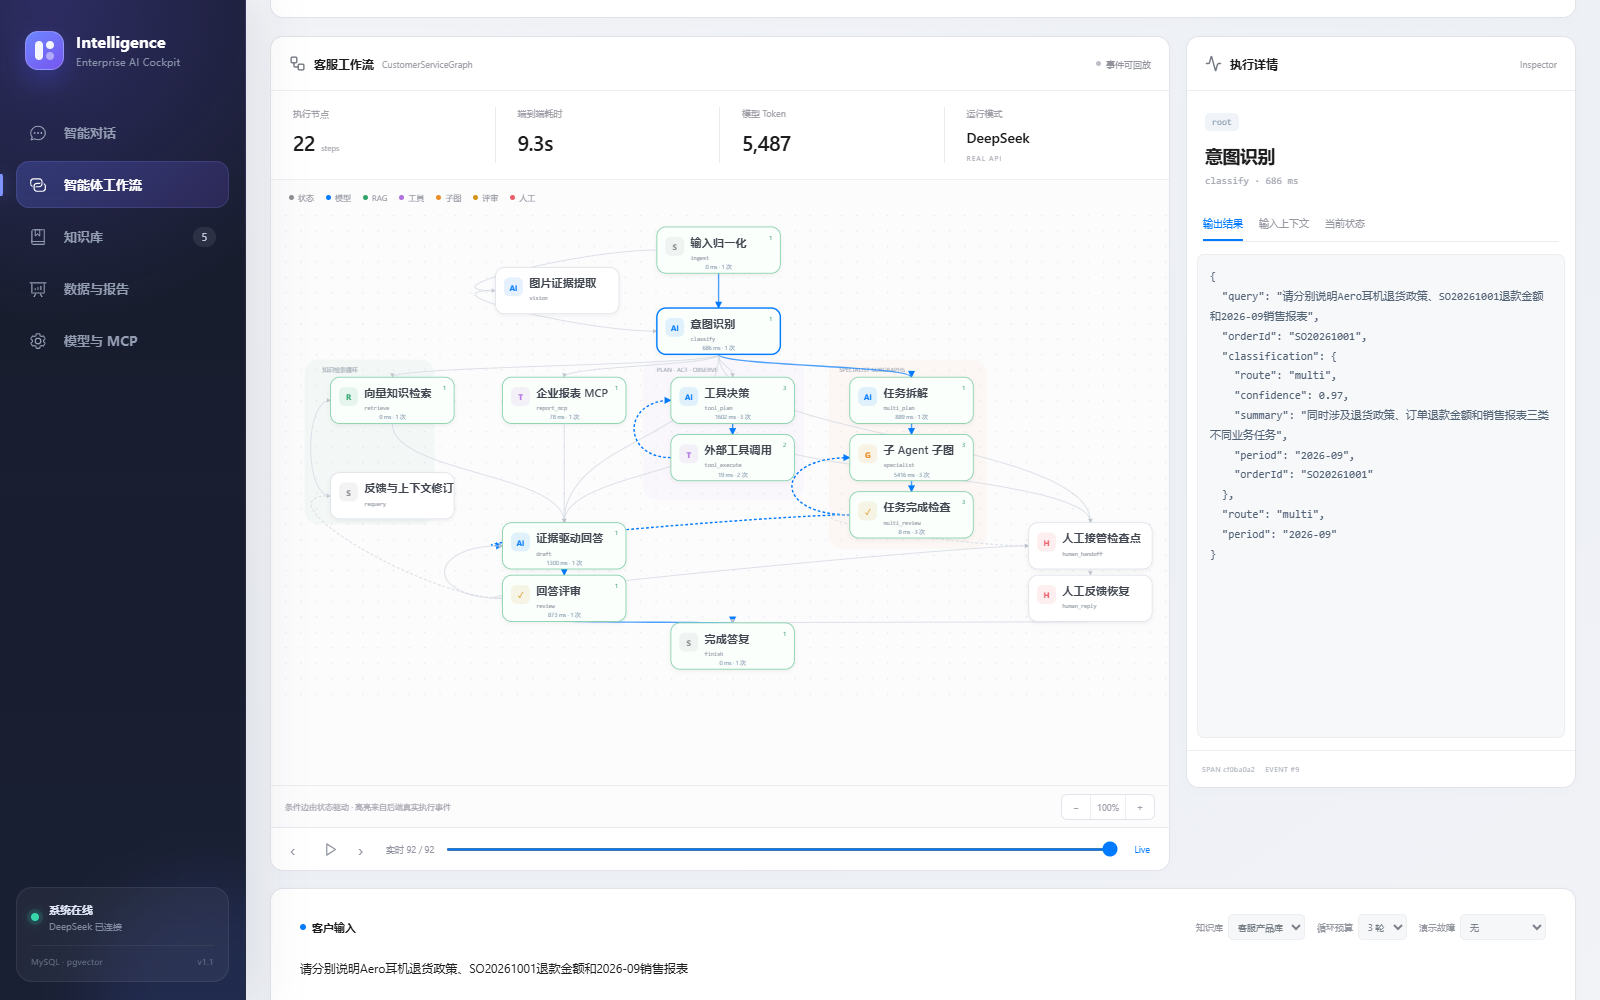
この境界を整理しておくと、画面操作の意味がぶれない。
- 「リプレイ一時停止」はフロントエンドの再生タイマーを止めるだけで、バックエンドで走行中のタスクは止めない。
- タスク自体を打ち切りたいときは「現在のワークフローを停止」から明示的にキャンセル要求を送る。
- 詳細欄の「現在の状態」は常に最新の実行状態を示し、リプレイ位置に合わせて巻き戻ることはない。各ノードの過去入出力は確認できるが、記録済みスナップショットの閲覧であり、任意ノードからの再実行ではない。
8つの業務シナリオで記録の過不足を確かめる
受け入れ確認では、単にノードが緑色になるかを見るのではなく、8つのシナリオごとに実際のデータ経路が記録から追えるかを確かめた。
| 業務シナリオ | 同じ記録の中で確認する内容 |
|---|---|
| 製品知識 RAG | retrieve が返した知識チャンク、類似度スコア、検索語と、回答が参照した根拠 |
| 画像とテキスト | vision が抽出した観察結果(故障コード E02 など)が後続の分類・検索に入ったか |
| 企業レポート MCP | モデルが「確認済み」と述べただけではなく、report_mcp の実際の戻り値があるか |
| ツール呼び出しループ | 各ラウンドの tool_execute のツール名、引数、観察結果、所要時間と個別の Span |
| マルチ Agent 協調 | 知識・レポート・注文の3専門家パス、外側の親 Span、サブグラフと最終集約入力 |
| 人的引き継ぎ | run.waiting、引き継ぎ資料、run.resumed、human_reply と、前段処理が重複しないこと |
| フィードバック再検索 | 2回の retrieve の間に requery が入り、検索クエリが実際に書き換わっていること |
| ツール異常と予算 | タイムアウト失敗が観察結果として残り、3ラウンド内の回復と上限到達時の人手移行が分かれること |
各シナリオの終了後、履歴を開き直して JSON を出力し、リプレイバーを先頭に戻してから完了ノードまで進め、その間にモデル呼び出しや注文照会が発生しないことを確認した。人手待機中のタスクも停止できるようにし、中断したデモが待機状態のまま残らないようにしている。
なお、「知識メンテナンス」と「共有ガイド」はワークベンチ側の入口であり、メイングラフ内の Agent ノードとしては扱わない。前者は検索対象資料の準備、後者はサンプル入力の読み込みを担当し、Graph へ入力が渡った後の実行事実だけを監視対象にしている。
ノード共通ラッパーとループ内の識別子設計
個別ロギングの代わりにラッパー関数を通す
業務ノードのメソッドごとにログ出力やイベント送信を書くと重複が増え、未捕捉例外のときに終了イベントを取りこぼしやすい。WorkflowEngine でノードを登録する際、メイングラフと専門家サブグラフの双方を共通の wrapped 関数で包んでいる。
String span = newSpanId();
emit("node.started", nodeId, path, span, input);
long started = System.nanoTime();
try {
    Map<String, Object> delta = businessStep(input);
    emit("node.completed", nodeId, path, span,
         Map.of("output", delta, "durationMs", elapsed(started)));
    return delta;
} catch (Exception e) {
    emit("node.failed", nodeId, path, span, publicError(e));
    throw e;
}
モデル呼び出しは別途 started / completed / failed とモデル名・用途・Token 使用量を記録し、parentSpanId で所属ノードに紐づける。画面に出すのはリクエスト内容、公開結果、構造化された分岐判断であり、モデル内部の思考過程は含めない。グラフの静的座標は /api/workflow/graph から取得し、実行イベントが通過エッジと完了ノードを決める。
ここで node.completed.output が持つのは、そのノードが返した「状態差分(Delta)」だけに限定している。完全な State と取り違えると、変更していないフィールドまで消えたように見えてしまうためだ。
ループとサブグラフでは nodeId だけで対応付けない
ツール分岐では tool_execute を複数回通過し、注文専門家のサブグラフ内部でも同じノード名を使う。nodeId だけで開始と終了を対応付けると、1ラウンド目の入力と2ラウンド目の結果を取り違える。そこでイベントには階層の異なる6つの識別子を持たせた。
| フィールド | コックピット内での役割 |
|---|---|
traceId | 実行全体の識別子(本プロジェクトでは Run ID と同一) |
nodeId | 業務ノード名(例 tool_execute) |
spanId | その1回の実行インスタンスID。同一ノードが複数回動けば毎回異なる値になる |
parentSpanId | モデル要求やサブグラフがどの外側呼び出しに属するかを示す |
path | グラフ実行パス。メイングラフは root、専門家は root/toolAgent[3] の形式 |
seq | 同一 Run 内で単調増加するイベント連番。再接続時の再送と重複排除に使う |
入出力は spanId + path でペアにする。専門家のライフサイクル記録は外側 specialist の Span を共有するが、path を加えることで外側の状態全体と混ざらない。[3] はその実行におけるタスク番号であり、注文専門家の固定枠ではない。
所要時間の集計も同じで、外側 specialist の時間には内部サブグラフの実行分がすでに含まれるため、全ノードの duration を単純合算すると親子で二重計上になる。画面全体の所要時間は先頭と末尾のイベント時刻差を使い、個別ノードの所要時間は単回または同名ノード累計として分けて表示している。
SSE 配信で気をつけた2つの点
各 Run は RunStore に順序付きイベントを保持し、コックピット既存の Spring WebFlux 上で Flux<ServerSentEvent<TraceEvent>> を返す。
履歴再送とリアルタイム購読を同じロック内で行う
実行中のタスクをブラウザが開いたとき、履歴の再送を終えて一度ロックを解放してから購読リストへ登録すると、そのわずかな隙間に発生したイベントを両方とも取り逃す競合が起きる。そのため seq 採番、カーソル以降の履歴取得、購読者登録を同じ Run ロック内で一括処理している。
id: 19
event: trace
data: {"seq":19,"type":"node.completed","nodeId":"tool_execute",...}
ブラウザは EventSource で受信し seq で重複を除外する。再接続時は after と Last-Event-ID の大きい方から後続イベントだけを再送し、人手待機中は15秒ごとの ID なしハートビートでプロキシ接続を維持する(カーソルは進めない)。
リバースプロキシのバッファリングを切る
本番の Nginx 経由で動かした際、実行中は画面が動かず、完了した瞬間に全経路が一気に点灯する事象があった。汎用プロキシが SSE チャンクを溜め込まないよう、レスポンスに X-Accel-Buffering: no と Cache-Control: no-cache を明示している。
イベント配列の前置スライスで動かすフロントエンドリプレイ
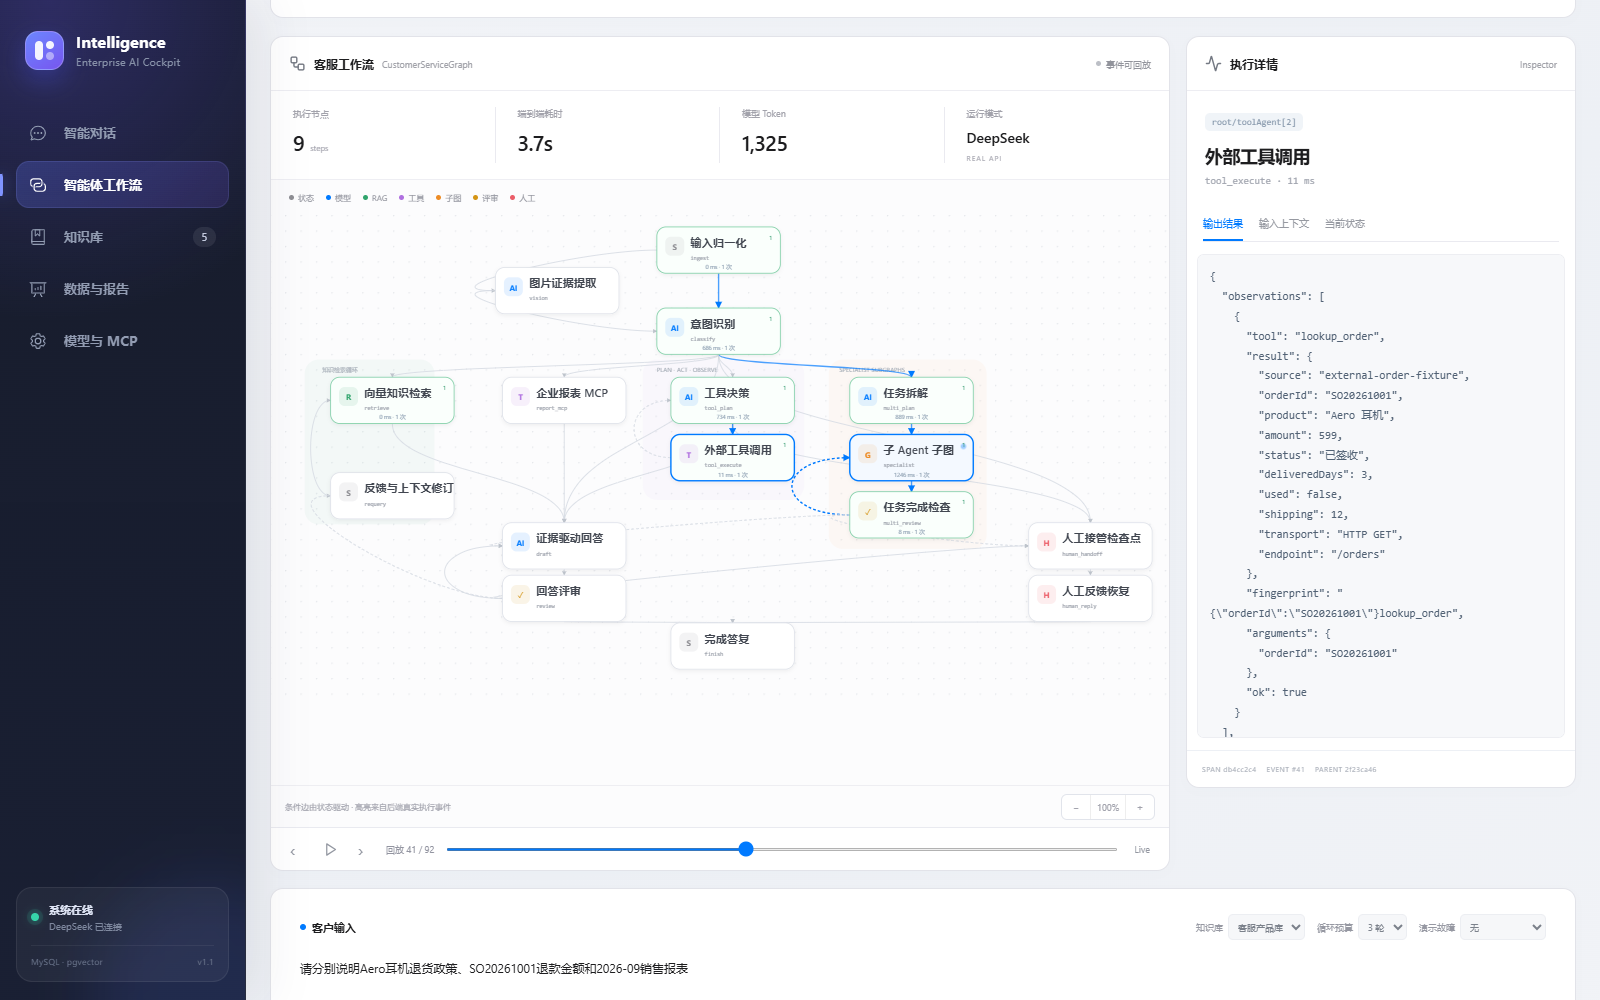
フロントエンドは受信済みの完全な events 配列を保持し、リアルタイム表示では全件、リプレイ表示ではカーソル手前までのスライスを参照する。
const visibleEvents = computed(() =>
  trackLive.value ? events.value : events.value.slice(0, cursor.value)
)
ノード状態、実行回数、通過エッジ、ツールラウンド、専門家カードはすべて visibleEvents から算出されるため、個別のアニメーションタイマーを持たずに同じ時点の状態へ揃えられる。
実装上の注意点は2つある。
- カーソルは配列インデックスであり
seqではない:1ノードの実行でエッジ通過、node.started、node.completedなど複数イベントが出るため、1ステップ進める操作は次のnode.completedの配列位置を探して移動する。連続再生は説明用に 600ms 間隔で進めており、実時間の再現ではない。 - ノード完了とツール成功は同じではない:外部 HTTP タイムアウトを業務コード側で捕捉すると
toolOutcome.ok = falseを返す。ノード自体は「失敗観察を記録する」処理を終えているためnode.completedになるが、ツールカード側は失敗表示になる。
スレッド上限による失敗の切り分け
全8シナリオのオンライン回帰テスト中、最初の3ラウンドでタイムアウト再試行、注文照会、599元の返金試算まで通ったのに、最後の review ノードで止まる事象が起きた。ノード記録をたどると、返金 API の再タイムアウトではなく java.lang.OutOfMemoryError: unable to create new native thread が記録されていた。Graph、HTTP、SSE、別プロセスの MCP Server が使うスレッド数の合計がプロセス上限の 90 に達していたためで、CPU・メモリ上限は据え置きのままスレッド上限を 128 に上げることで全8シナリオが通過した。業務ループの回数予算と実行環境のリソース上限を切り分けるうえで、実行記録がそのまま役に立った。
永続化の範囲とマスキングの境界
ルートノードの区切り、実行完了、人的復帰、キャンセルのタイミングで、一時ファイル書き込みとアトミック置換により shared/workflow/runs へ JSON を保存する。release 切り替えの対象外ディレクトリのため、フロントエンドや JAR を更新しても履歴を参照できる。
ただし emit ごとに即座にディスクへ書き込むイベントDBではないため、プロセスが異常終了した場合は直近チェックポイント以降のイベントが欠ける可能性がある。起動時に残っていた RUNNING は INTERRUPTED に更新し、人手待機は保持して保存済み状態から HumanResumeGraph に入る。保持件数は最大 100 件(API 表示は直近 40 件)で、内部制御フィールドや元画像バイナリ、api-key は除外しているが、今後実データを接続する際はフィールド単位のマスキング、閲覧権限、保存期間を別途設ける必要がある。
技術共有向けの agentDemo からスマートコックピットへの統合までを通して実感したのは、AI エージェント開発の重心が、単なるプロンプト調整からバックエンドの状態付きオーケストレーションとフロントエンドの可観測性へと移っているということだ。
リプレイ動作はスマートコックピットのワークフローページで直接試すことができ、状態グラフ側の設計は前回の記事にまとめている。