監査可能なAIクオンツ研究システムの設計と実装
予測結果の過信を排し、データ取得・非同期タスク・マルチファクター評価・バックテスト検証の全工程を監査可能な状態機械として設計・運用する。
クオンツ投資戦略の研究開発において、単一の銘柄予測や過剰適合された資産曲線のみに依存することは重大な運用リスクを伴います。本番環境で真に問われるのは、データ取得のタイムスタンプ、タスク障害時の冪等な再試行、モデル推論の根拠追跡、そしてバックテストにおける先読みバイアス(Look-ahead bias)の排除です。
本プロジェクト(AI Quant System)では、データ収集からファクター抽出、バックテスト、Walk-forward検証に至る全工程を追跡可能な「状態機械とバージョン管理」の枠組みとして実装しました。
システムアーキテクチャと研究ループ
フロントエンドにはReactとViteを採用し、市場データ、ファクターランキング、センチメントシグナル、バックテスト結果、および学習モジュールを一元管理します。FastAPIバックエンドはAPIインターフェース層に専念し、時間のかかるデータ同期、LLM推論、バックテスト計算は独立したワーカープロセスに委譲します。MySQLは最終結果の永続化に加え、タスク状態、データセットのバージョン管理、実行ログを保持します。
研究タスクのライフサイクル:
1. フロントエンドからパラメータ送信 → APIがタスクを queued 状態で登録
2. 独立ワーカーがタスクを取得 → 状態を running に更新
3. データ取得、センチメント抽出、バックテスト計算の進捗を段階的に記録
4. 正常終了時は構造化結果を保存し success、異常時は診断ログを記録して failed に遷移
5. サーバー再起動やプロセス停止が発生しても、DB上の状態遷移ログから復旧可能
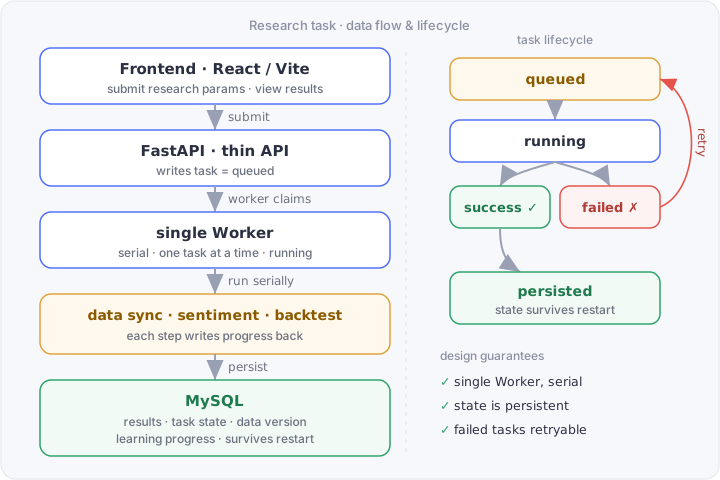
2GB RAMの限られたクラウド環境において、単一ワーカーによる順次処理を採用することで、メモリ消費の急激なスパイクを抑え、障害発生時の原因切り分けを容易にしています。
状態機械によるタスクの永続化と冪等性の確保
タスクを一過性のメモリ内処理ではなく、データベースに記録される確定的な状態機械としてモデル化しています:
queued: タスク登録完了、ワーカーの実行待ちrunning: ワーカーによる処理実行中success: 処理正常完了、結果の永続化完了failed: エラー発生、スタックトレースと診断情報を記録
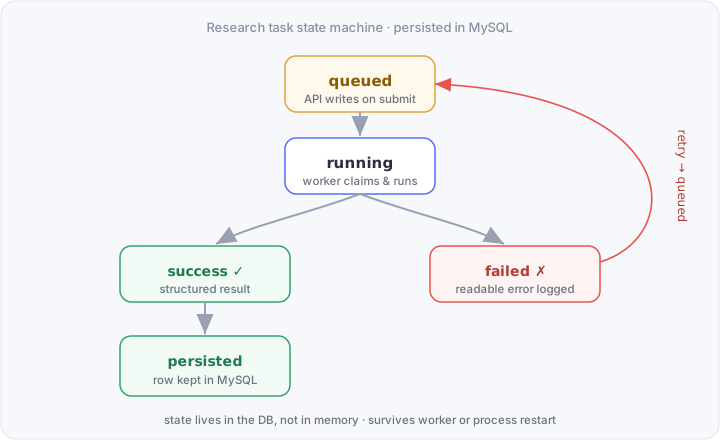
この設計により、プロセスが不意に終了した場合でも、孤立した running タスクを検知して安全に再実行できます。また、再試行時の冪等性を保証するため、実行開始時に該当タスクの既存派生データを一旦クリーンアップしてから再計算を行います。
# タスク実行と状態遷移の制御ロジック(概念実装)
def run_task(task):
    task.mark("running")
    try:
        clean_previous_outputs(task)  # 再試行時の冪等性を担保
        result = execute(task)        # データ取得 / ファクター計算 / バックテスト
        task.save(result)
        task.mark("success")
    except Exception as e:
        task.mark("failed", error=format_exception(e))
        log_diagnostics(task, e)
データセットのバージョン管理とPoint-in-Timeの厳密化
最新スナップショットのみを上書き保存する方式では、過去のバックテスト結果を正確に再現することが不可能です。本システムでは、すべての生データに取得タイムスタンプとバッチIDを付与し、バージョン管理されたデータセットとして分離保存します。
バックテスト実行時には、指定された特定バージョンのデータセットのみを参照することで、過去の実験結果の完全な再現性を担保します。
LLMセンチメント分析の構造化と監査証跡
大規模言語モデル(LLM)は売買判断を直接下すのではなく、ニュースや開示情報の「構造化ファクター抽出」に限定して適用します。モデルはセンチメント分類(bullish / neutral / bearish)、正規化スコア、信頼度、および根拠要約(reason)を出力します。
生データである開示テキストは不変(Immutable)として保持し、モデル名と推論時刻を付与した派生データとして保存することで、プロンプト改善やモデル変更時の再評価を可能にしています。
{
  "label": "bullish",
  "score": 0.62,
  "confidence": 0.71,
  "summary": "四半期売上ガイダンスの上方修正",
  "reason": "開示情報にて次期出荷数量が前年比20%増と予測",
  "model": "llm-extractor",
  "analyzed_at": "2026-05-11T09:20:00Z"
}
Walk-Forward分析によるアウトオブサンプルの検証
静的なインサンプル検証による過剰適合を防止するため、Walk-Forward分析を採用しています。最適化期間(In-Sample)でパラメータを選定し、直後の検証期間(Out-of-Sample)に対して1度だけバックテストを実行します。各検証期間のリターンを連結することで、将来情報を参照しない実運用に近いパフォーマンス評価を実現します。
軽量インフラにおける運用制御
本システムは2GBメモリの単一ノード上で、クロスボーダーEC分析や社内AIコックピットと共存稼働しています。そのため、以下のリソースガバナンスを徹底しています:
- データベース接続プール(SQLAlchemy pool size)の厳格な上限設定
- pandasデータフレーム処理時の不要メモリ即時解放
- 定期的なログローテーションと古いキャッシュの自動破棄
本システムの稼働状態と研究コンソールは /quant/ でご確認いただけます。
本記事は定量的手法とシステム設計に関する技術記録であり、投資助言を提供するものではありません。