企業向けAIコックピット:RAG・ベクトル検索・リアルタイムストリーミングの実装
異種ストレージの分離、pgvectorと語彙検索の二系統設計、SSEストリーミングパイプライン、および厳格なリソース分離による高可用性AI基盤の構築。
Retrieval-Augmented Generation (RAG) を単なるチャットUIのプロトタイプから本番環境の企業向けコックピットへと昇華させるには、メタデータとベクトルの整合性同期、削除処理の非同期カスケード、引用元の証跡管理、SSEによる真のストリーミング配信、そしてリソース分離の確立が不可欠です。
本プロジェクト(Enterprise AI Cockpit)では、障害時のフォールバック経路と厳格なリソース境界を設けたエンタープライズAIアーキテクチャを実装しました。
2026年8月更新: 本稿は初期の「ベクトル優先・語彙フォールバック」構成を記録しています。現在の本番環境は、構造対応チャンク分割、Dense+Keywordハイブリッド検索、Reciprocal Rank Fusion (RRF)、有効期限フィルタリング、隣接チャンク結合へ進化しています。詳細な調整手法は企業向けRAGにおける知識工学とコックピットアーキテクチャをご参照ください。
異種ストレージの分離と責務分担
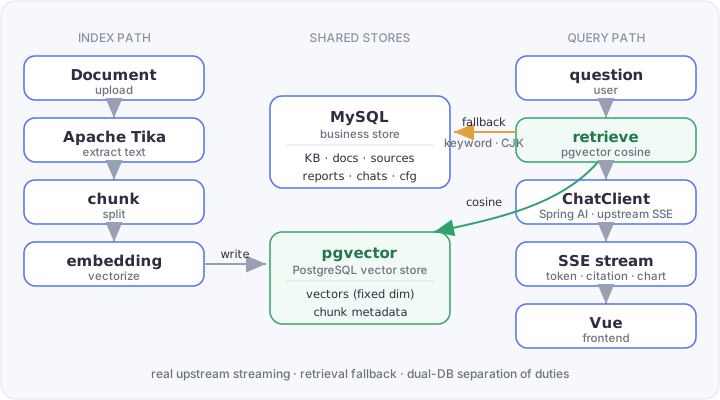
永続化層では、アクセスパターンの異なる2種類のデータベースを分離しています:
- MySQL: ナレッジベース設定、ドキュメントメタデータ、外部データソース接続、レポートテンプレート、非同期実行ログ、会話履歴、RBAC権限などの構造化データを管理。
- PostgreSQL + pgvector: 固定次元の埋め込みベクトルとチャンクメタデータを格納。
リレーショナル業務データはACIDトランザクション、外部キー制約、多次元フィルタリングを重視し、ベクトル検索はCosine距離に基づく高次元の近似最近傍探索(ANN)を重視します。両者を分離することで、双方のインデックス性能とクエリ効率を最適化しています。
ドキュメントの登録パイプライン:
- テキスト抽出: Apache TikaによりPDF、Word、Markdown等からプレーンテキストを抽出;
- チャンク分割: 境界の文脈欠落を防ぐため、一定の文字数とオーバーラップ幅で分割;
- 埋め込み生成: Embeddingモデルにより固定次元ベクトルへ変換;
- 二重永続化: pgvectorにベクトルとチャンクメタデータ(doc_id, chunk_index, span)を格納し、MySQLにドキュメントメタデータをコミット。
# ドキュメント登録フロー
raw_text = tika.extract(file)
chunks   = split(raw_text, size=500, overlap=50)
for chunk in chunks:
    vector = embed(chunk.text)
    pgvector.insert(vector, metadata={doc_id, chunk_index, span})
mysql.save(doc_metadata)
検索クエリ実行時、システムはpgvectorによるCosine類似度検索を優先し、上位k件のチャンクをプロンプトコンテキストに注入します:
# 検索クエリ実行フロー
query_vector = embed(user_question)
hits = pgvector.search(query_vector, top_k=5)
if vector_unavailable or len(hits) == 0:
    hits = mysql.keyword_cjk_search(user_question)  # CJK語彙検索へフォールバック
context = [hit.chunk for hit in hits]
高可用性を確保するため、ベクトルストアの遅延や障害時には、MySQLの全文・CJK語彙検索へと自動フォールバックするセーフティネットを実装しています。
| 項目 | MySQL | PostgreSQL + pgvector |
|---|---|---|
| 格納データ | ナレッジベース、ドキュメントメタ、データソース、テンプレート、ログ、対話履歴 | 固定次元ベクトル、チャンクメタデータ |
| アクセスパターン | トランザクション、条件抽出、ページネーション、JOIN | Top-k 近似最近傍探索 (ANN) |
| 主たる責務 | 業務ステータス管理と永続化 | セマンティック検索と類似度計算 |
| 検索における役割 | CJK語彙検索による縮退フォールバック | Cosine類似度による一次検索 |
ドキュメント削除時は、MySQL側で削除フラグを更新した上でpgvectorのチャンクを非同期パージし、定期バッチにより孤立ベクトルの整合性を担保します。
真のSSEエンドツーエンド・ストリーミング設計
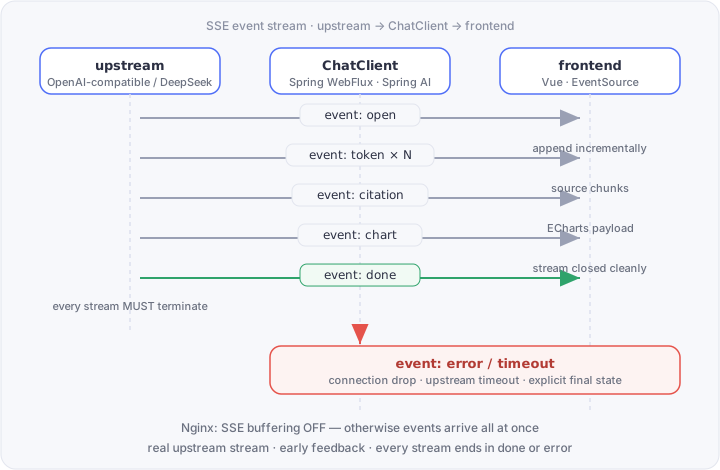
バックエンドにはSpring WebFluxとSpring AIを採用しています。ChatClient が上流のDeepSeek/OpenAI互換エンドポイントからServer-Sent Events (SSE) を受信し、Vueフロントエンドへと構造化イベントをリアルタイムに中継します。
生成完了後にローカルで文字送りアニメーションを行う疑似ストリーミングとは異なり、上流モデルの最初のトークン生成と同時にフロントエンド描画を開始することで、Time-to-First-Token (TTFT) を最小化します。
イベントストリームのライフサイクル:
event: open           // 接続確立
event: token   × N    // 逐次テキストトークン
event: citation       // 検索ヒットした根拠チャンクのメタデータ
event: chart          // ECharts描画用の構造化データ
event: done           // 正常完了
event: error/timeout  // 異常終了・タイムアウトの明示的クローズ
Spring WebFluxの Flux によるリアクティブ・バックプレッシャーにより、高負荷時でもバッファの肥大化を抑制します。また、すべてのSSEストリームは done または error/timeout イベントで確実に終端され、クライアントUIのハングアップを防ぎます。リバースプロキシのNginxでは proxy_buffering off を設定し、イベントの即時配送を保証しています。
フロントエンドでは、回答テキスト、引用バッジ、EChartsグラフが同一画面内でシームレスに統合描画されます。
機能範囲とセキュリティ境界
本プラットフォームは、レポートテンプレート、非同期実行ログ、データソース接続検証、およびModel Context Protocol (MCP) ツール連携を包含しています。
主要なセキュリティ制約:
- 操作権限の分離: 公開デモ環境は閲覧専用とし、アップロードやレポート生成等の重量処理は短命なAction Tokenで保護;
- 引用根拠の義務付け: モデルの回答は検索チャンクの根拠提示を必須とし、根拠のない断定を抑制。
リソース制約下での運用設計
2GB RAMの限られたサーバー環境で他サービスと共存するため、フロントエンドは静的ファイルとして事前ビルドし、バックエンドは厳格なJVMリソース制限下で稼働させています:
-Xmxおよび-XX:MaxMetaspaceSizeによるヒープ・メタスペースの上限固定- NettyのオフヒープI/Oバッファを制御する
-XX:MaxDirectMemorySizeの明示 - データベース接続プールとスレッド数の最小化
システム全体のメモリ逼迫時には、コックピットサービスを最優先で縮退・一時停止させるポリシーを適用し、基盤インフラの継続運用を最優先としています。
稼働中のシステムは /smartCockpit/ で公開されています。