LLMセンチメント因子のウォークフォワードとサンプル外検証
大規模言語モデルによる構造化イベント抽出、時系列アライメント、指数減衰モデリング、およびWalk-Forwardによるアウトオブサンプル増分テストの実践。
クオンツ戦略の研究開発において、大規模言語モデル(LLM)に対して直接売買判断をプロンプトで指示することは、ブラックボックス化、時系列境界の曖昧化、プロンプト変更による戦略の不安定化を招きます。また、自然言語の文脈理解とポートフォリオのリスク最適化が混同され、要因分解(Factor Attribution)やリスク管理が困難になります。
本システムでは、LLMの役割を「非構造化テキストからの構造化イベント抽出器」に限定し、ダウンストリームのマルチファクターモデルとリスク管理を決定論的な定量的フレームワークに委ね、アウトオブサンプル(OOS)実験を通じて真の超過リターン(Alpha)を検証します。
構造化イベント抽出と監査設計
ニュース記事や適時開示情報がシステムに入力されると、元URL、公開日時、生テキストのコンテンツハッシュ(SHA-1)が直ちに永続化されます。言語モデルはテキストを解析し、標準化された構造化属性を出力します:
- センチメント分類:
bullish(強気)、neutral(中立)、bearish(弱気); - 正規化スコア:
[-1.0, 1.0]の範囲にスケーリング; - 信頼度スコア:
[0.0, 1.0]の範囲; - 要約および判断根拠 (
reason): センチメント判断を裏付ける事実要素を抽出; - モデルメタデータ: モデルバージョン識別子と推論日時を記録。
構造化イベントのスキーマ定義:
{
  "event_id": "sha1(raw_text)",
  "published_at": "2026-03-11T09:20:00Z",
  "source_url": "https://...",
  "label": "bullish",
  "score": 0.62,
  "confidence": 0.71,
  "summary": "四半期売上ガイダンスの上方修正",
  "reason": "開示情報にて次期出荷数量が前年比20%増と予測",
  "model": "llm-vX",
  "analyzed_at": "2026-03-11T09:24:10Z"
}
「生データは不変(Immutable)、派生ファクターは再計算可能」という原則を徹底しています。プロンプトやモデルを更新した場合でも、蓄積された生テキストに対して過去分の再抽出を実行し、異なるファクターバージョン間でバックテスト比較を行うことができます。
時系列アライメント・重複排除・指数減衰モデル
センチメントファクターにおける先読みバイアス(Look-ahead bias)を完全に排除するため、以下の時系列規律を適用します:
- 厳格なタイムスタンプ同期: イベントがファクター計算に算入される時刻は、媒体公開日時(
published_at)に基づき、戦略のリバランス判断時刻より先行していなければならない; - マルチソース重複排除: 複数メディアによる同一ニュースの転載はハッシュクラスタリングによって統合し、重複計上による人為的な「市場コンセンサス」の歪みを排除;
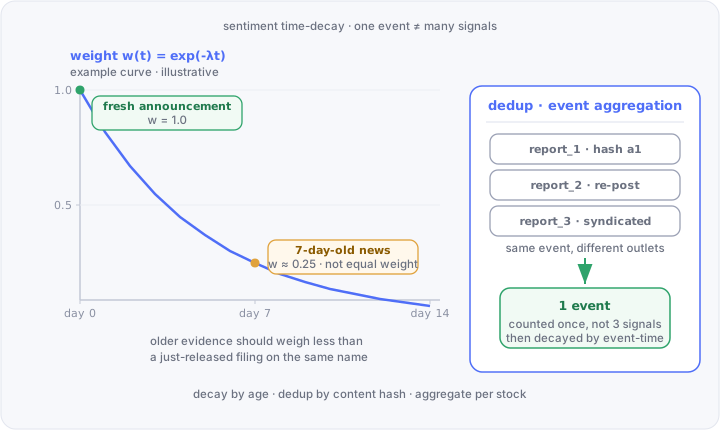
- 指数時間減衰: ニュースの影響度は時間とともに減衰するため、銘柄ごとの過去イベントを指数減衰ウィンドウで加重集計:
センチメントも永続的ではありません。7日前のニュースと、たった今出たリリースを同じ重みで扱うべきではないのです。そこでシステムは、イベント時刻をもとに減衰ウィンドウを構築し、ニュースが古くなるにつれて重みを下げ、銘柄ごとにセンチメントスコアを集約します。ひとつの例示的なやり方は、各イベントに指数減衰の重みを与えることです(下の式はあくまで例であり、半減期は訓練期間で選ぶべきで、テスト期間に合わせて調整してはいけません)。
```text
w(t) = exp(-λ · Δt)          # Δt = リバランス判断時刻 − ニュース公開日時(日数換算)
Score_stock = Σ_i  w(t_i) · Confidence_i · Score_i
対照実験とインクリメンタル・アルファの評価
高い分類精度が必ずしも戦略の収益性に直結するわけではありません。情報がすでに市場に織り込まれている場合や、ファクター導入による売買回転率(Turnover)の増加コストが超過リターンを上回る場合、ファクターの正味価値はゼロになります。
システムでは、同一の銘柄ユニバース、取引コスト前提、バックテスト期間の条件下で、ベースライン戦略(価格・出来高・財務ファクターのみ)とセンチメントファクター追加戦略を比較する対照実験を実施します:
| 評価指標 | ベースライン(LLMなし) | センチメント追加戦略 | 主たる検証観点 |
|---|---|---|---|
| サンプル外 年率リターン | 基準値 | 検証対象 | 正味の超過リターン(Alpha)が存在するか? |
| 最大ドローダウン / ボラティリティ | 基準値 | 検証対象 | リスクの不当な増大を招いていないか? |
| 売買回転率 / 取引摩擦コスト | 基準値 | 検証対象 | スプレッド・手数料を差し引いても利益が残るか? |
| 市場レジーム別耐性 | 基準値 | 検証対象 | トレンド相場とレンジ相場の双方で安定しているか? |
| 推論遅延 / APIコスト | — | 実測値 | 実運用のリバランス要件に合致するか? |
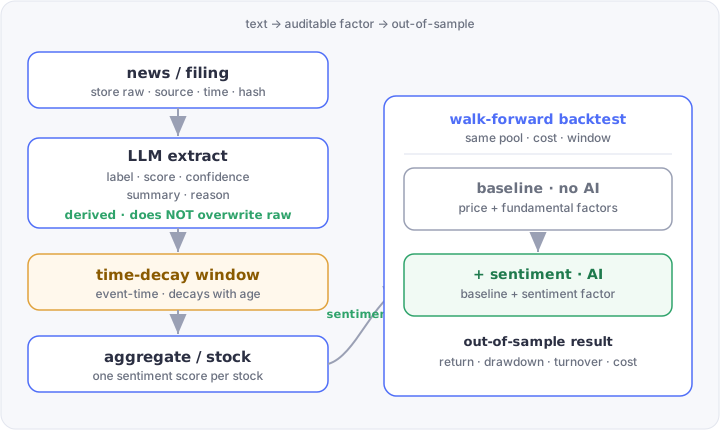
Walk-Forward分析による過剰適合防止
静的なインサンプル検証による過剰適合を防止するため、Walk-Forward クロスバリデーションを適用します:
- バックテスト全期間を複数のローリング検証ウィンドウ(学習期間 + 検証期間)に分割;
- ファクター重み、減衰パラメータ、売買閾値の最適化はインサンプル(IS)学習期間内のみで完結;
- 確定したパラメータを直後のアウトオブサンプル(OOS)検証期間に対して1度だけ適用;
- 各検証期間の運用実績を連続的に結合して最終的な戦略資産曲線を構築。
Window 1: [--- 学習 1 ---][ 検証 1 ]
Window 2:        [--- 学習 2 ---][ 検証 2 ]
Window 3:               [--- 学習 3 ---][ 検証 3 ]
連結OOSパフォーマンス:          [ 検証 1 ][ 検証 2 ][ 検証 3 ]
検証期間で想定外のドローダウンが発生した場合でも、事後的なパラメータ再調整は行わず、レジーム感応度の特性として記録します。
まとめと実装環境
定量的リサーチにおいて、LLMの最大の強みは膨大な非構造化開示情報を再現可能な構造化データへと蒸留することにあります。ポートフォリオ構築とリスク管理は決定論的モデルが規律をもって執行し、ファクターの有効性は厳格なサンプル外テストによってのみ証明されます。
本ファクターパイプラインおよびWalk-Forward分析フレームワークは、AI Quant System に統合されています。
本記事は定量的手法とシステム設計に関する技術記録であり、投資助言を提供するものではありません。