スマートコックピットで状態グラフを使って Agent ワークフローを組む
単発のプロンプトでは複雑な業務を完結できない理由から出発し、Graphベースの状態図モデル、ツールループ、マルチ専門家協調、さらにCoding Agentやサイバネティクス(制御論)との構造的な共通点を整理する。
技術共有や大規模言語モデル(LLM)の応用について話すとき、つい最初から Spring AI、LangGraph、RAG、MCP といったフレームワーク名を並べてしまいがちだ。しかし一通り聞いたあと、多くの人が抱く疑問はシンプルだ。「普段モデルの API を呼んでチャットするだけでも十分スムーズなのに、なぜわざわざ複雑なワークフロー編排を作る必要があるのか?」
Agent を作り始めた頃、私自身も同じ段階を通った。考えが変わったのは、実際の業務リクエストを AI で処理しようとしたときだった。
「注文 SO20261001 を調べて、あと何元返金できるか教えてほしい。」
一見すると普通の自然言語の質問だが、業務コードを書いてみると、単発のプロンプトだけでは完結できないことがすぐに分かる。
モデルがこの文を受け取った瞬間には、その注文が配達済みか、何日前に届いたのか、開封されたかどうかを知る由もない。プロンプトをどれほど長く書いて「ステップ1で注文を調べ、ステップ2で金額を計算する」と文章で出力させても、自然言語上の計画はシステム上の実行ではない。プログラムがいったん立ち止まり、抽出した注文番号で注文サービスに問い合わせ、「受領後3日・未開封」という事実を受け取ってモデルへ戻して初めて、返品規定に沿った正確な返金額を計算できる。
社内勉強会向けに Vue 3 + Spring AI Alibaba Graph + DeepSeek で試作した agentDemo は、その後スマートコックピット(enterprise-ai-cockpit リポジトリ)へ統合した。以下ではプロジェクトのアーキテクチャ図・フロー図・実装コードをもとに、業務向けの Agent にワークフロー編排が不可欠な理由と実装の勘所をまとめる。
単発の API 呼び出しから目標駆動の状態付きシステムへ
基本的な LLM の使い方は明快だ。System Prompt にユーザーの質問をつなぎ、Chat Completion API を1回呼び出して Markdown を描画する。週報の下書きや文章の推敲、単一ドキュメントの要約なら、この「1回きりのリクエスト」で十分役に立つ。
ただ、その延長で「プロンプトさえ作り込めば Agent になる」と考えると、実業務ではすぐに3つの壁にぶつかる。
- ステップ間の強い動的依存:返金の例のように、ステップ2の計算入力はステップ1の API 戻り値(Observation)に依存しており、取得前に推論を進めれば当て推量になる。
- 確定的な業務ルールの制約:規定の案内は最新のベクトル知識ベースに準拠し、売上分析は管理された MCP インターフェース経由で取得し、返金試算は専用ロジックを通し、感情的なクレームは人手へ引き継ぐ必要がある。業務マニュアルやテーブル定義、全 API を1つの長大なプロンプトに詰め込めば、コンテキスト圧迫と注意力の希薄化で信頼性が大きく下がる。
- 環境変動とフォールトトレランス:外部 API のタイムアウト、初回検索の取りこぼし、JSON 形式の崩れが起きた際、単発呼び出しでは全体をエラー終了させるしかなく、状態を保ったまま再試行・修復する仕組みを持てない。
つまり Agent とは魔法のプロンプトでも単なるモデル API でもなく、目標に向けてタスクを前進させる状態付きのエンジニアリングシステムだ。アーキテクチャ上は、推論と実行環境を明確に切り分ける必要がある。
- 頭脳(LLM / Reasoner):非構造テキストの意味理解、意図抽出、および既知の事実に基づく次の行動提案(Policy Inference)を担う。
- 身体と実行コンテナ(Host Runtime & State Container):ステップをまたぐ状態の保持・永続化、ツールの安全な実行、権限検証、ラウンド予算制御、人的引き継ぎからの復帰を担う。
| 比較軸 | 単発 Prompt + API | 状態グラフによるワークフロー編排 |
|---|---|---|
| コンテキスト供給 | 実行前に一括で静的結合。過多や漏れが起きやすい | 実行に伴い動的注入。前段ツールの実結果が次段の入力になる |
| 外部アクション実行 | 引数テキストの生成のみ。自力では外部呼び出しを完結できない | ホスト側で引数検証・実通信・例外捕捉を実行する |
| 分岐ルーティング | 単一回答の文章内でモデルが分岐を推測 | 状態マシンの条件付きエッジ(Conditional Edge)で確定的に遷移 |
| 異常からの回復 | 1箇所の例外でタスク全体が終了 | 例外を Observation として状態に記録し、再試行・縮退・人手移行を選択 |
| タスク終了基準 | モデルの生成終了(EOS)で完了 | 業務受け入れ条件・根拠の充足・最大実行予算で総合判定 |
状態グラフの計算モデルと技術選定
線形パイプラインだけでは足りない理由
編排を始めたばかりの頃は、A -> B -> C のような線形パイプラインを思い浮かべやすい。定型フローには向いているが、検索結果が不十分なときのクエリ書き換えや、ツールエラー時の再判断といったループ(Loop)とフィードバック修正が入ると、深い再帰やグローバル変数だらけの while ループを抱え込むことになる。
状態グラフ(State Graph)は分岐と循環を含む制御フローを4つの要素で整理する。
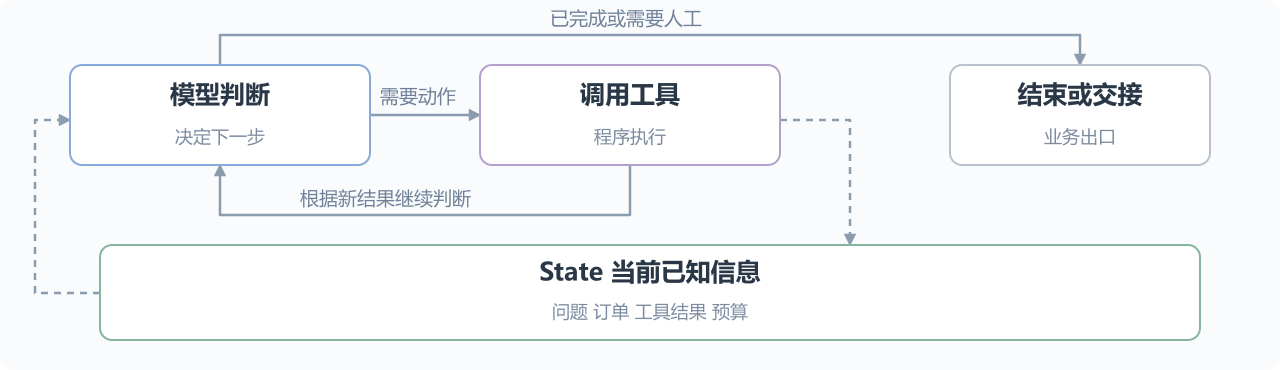
- 状態(State / ブラックボード):グラフ全体のライフサイクルを通じて共有される記憶容器。質問文、意図と確信度、検索チャンク、ツールの要求と実結果(Observations)、反復回数、回答ドラフトを保持し、明確なマージ戦略に従って更新する。
- ノード(Node):単一責務の関数として現在の State を読み取り、処理を実行して状態差分(State Delta)を返す。リクエストをまたぐプライベート状態は持たない。
- エッジと条件付きエッジ(Edge / Conditional Edge):固定遷移に加え、現在の State 値から次の遷移先を動的に算出する。
- ループと安全予算(Cycle & Budget):上流ノードへ戻るエッジによって ReAct(「判断 — 実行 — 観察 — 再判断」)ループを自然に表現し、再帰上限(Recursion Limit)と業務ラウンド予算(Budget)を超えた時点で人手対応へ切り替える。
Java エコシステムで Spring AI Alibaba Graph を選ぶ
Python では LangGraph がいち早くグラフ計算と有限状態機械(FSM)の発想を Agent ランタイムへ導入したが、企業の基幹サービスや高並行バックエンドでは Java が依然として主力だ。
Agent 機能のためだけに別建ての Python サービスを保守すると運用や DB 連携のコストが増えるため、Java + Spring Boot ベースのスマートコックピットでは同じ技術スタック内で Spring AI Alibaba Graph を採用し、型安全性や DI、Spring エコシステムをそのまま活用した。
スマートコックピットにおけるカスタマーサービス設計
実務の問い合わせには多様なパターンが混在する。
- 相談 A:「Aero イヤホンの返品規定は? 受領3日で未使用なら返品できる?」(規定検索と条文の出典提示が必要な RAG 質問)
- 相談 B:赤点滅するランプのスクリーンショットを添えて「これは何の異常? どう対処すればいい?」(E02 エラーコードを視覚抽出してからマニュアル検索)
- 相談 C:「注文 SO20261001 を調べ、実際の状態に基づいて返金可能額を試算してほしい。」(前後依存のある動的ツール呼び出し)
- 相談 D:「2026年9月の売上レポートを照会し、売上高と注文数を教えて。」(MCP プロトコルによる社内レポートサービスの動的発見と呼び出し)
- 相談 E:「イヤホンの返品規定、SO20261001 の返金可能額、9月の売上レポートをそれぞれ説明して。」(タスク分解と複数専門家の協調が必要な複合依頼)
- 相談 F:「補償金額にまったく納得できない、責任者に対応してほしい!」(紛争または低確信度意図として全コンテキストを保存し人手へ引き継ぐ)
これらを受け止めるエンドツーエンドの状態グラフトポロジと実行時データフローは次の通りだ。
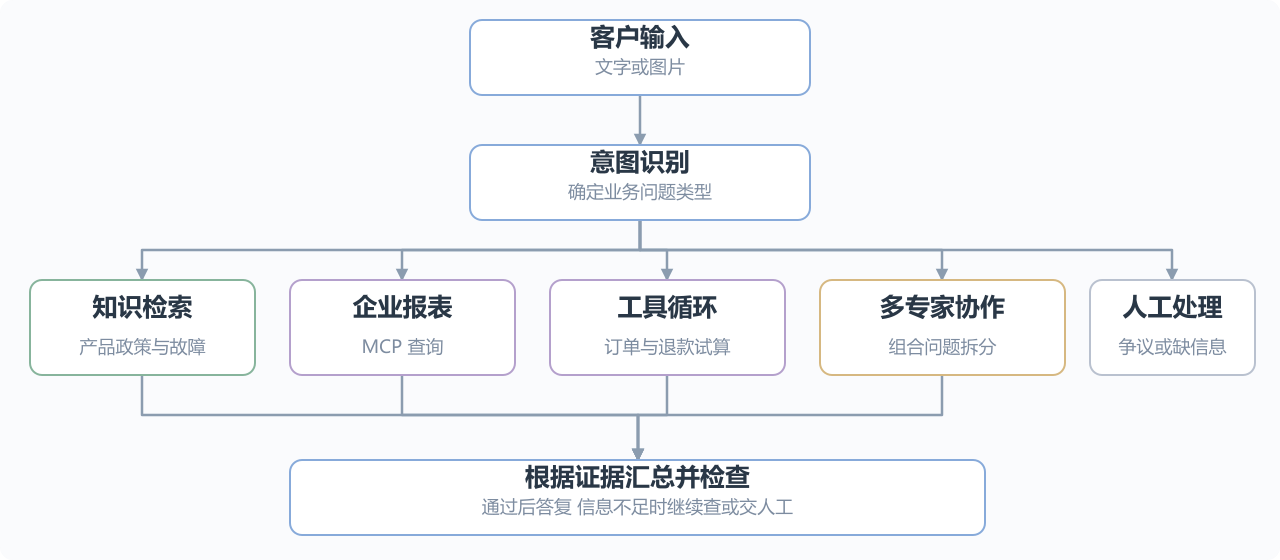
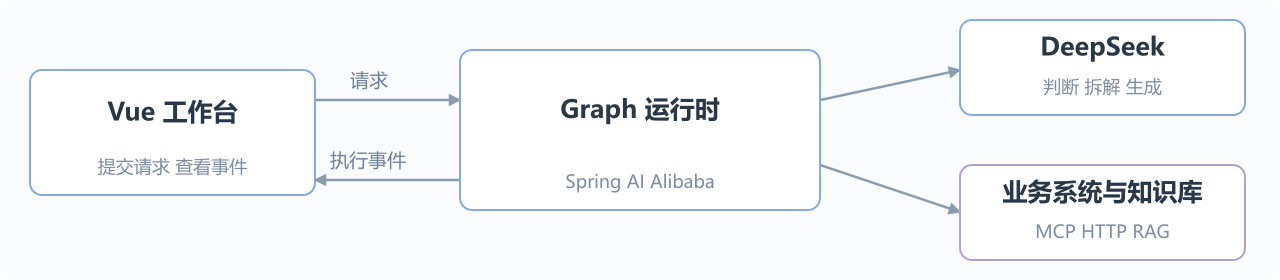
コックピット上のワークベンチでは、8つのシナリオ入口、実行履歴、メイングラフ可視化、ノード詳細パネルを提供している。
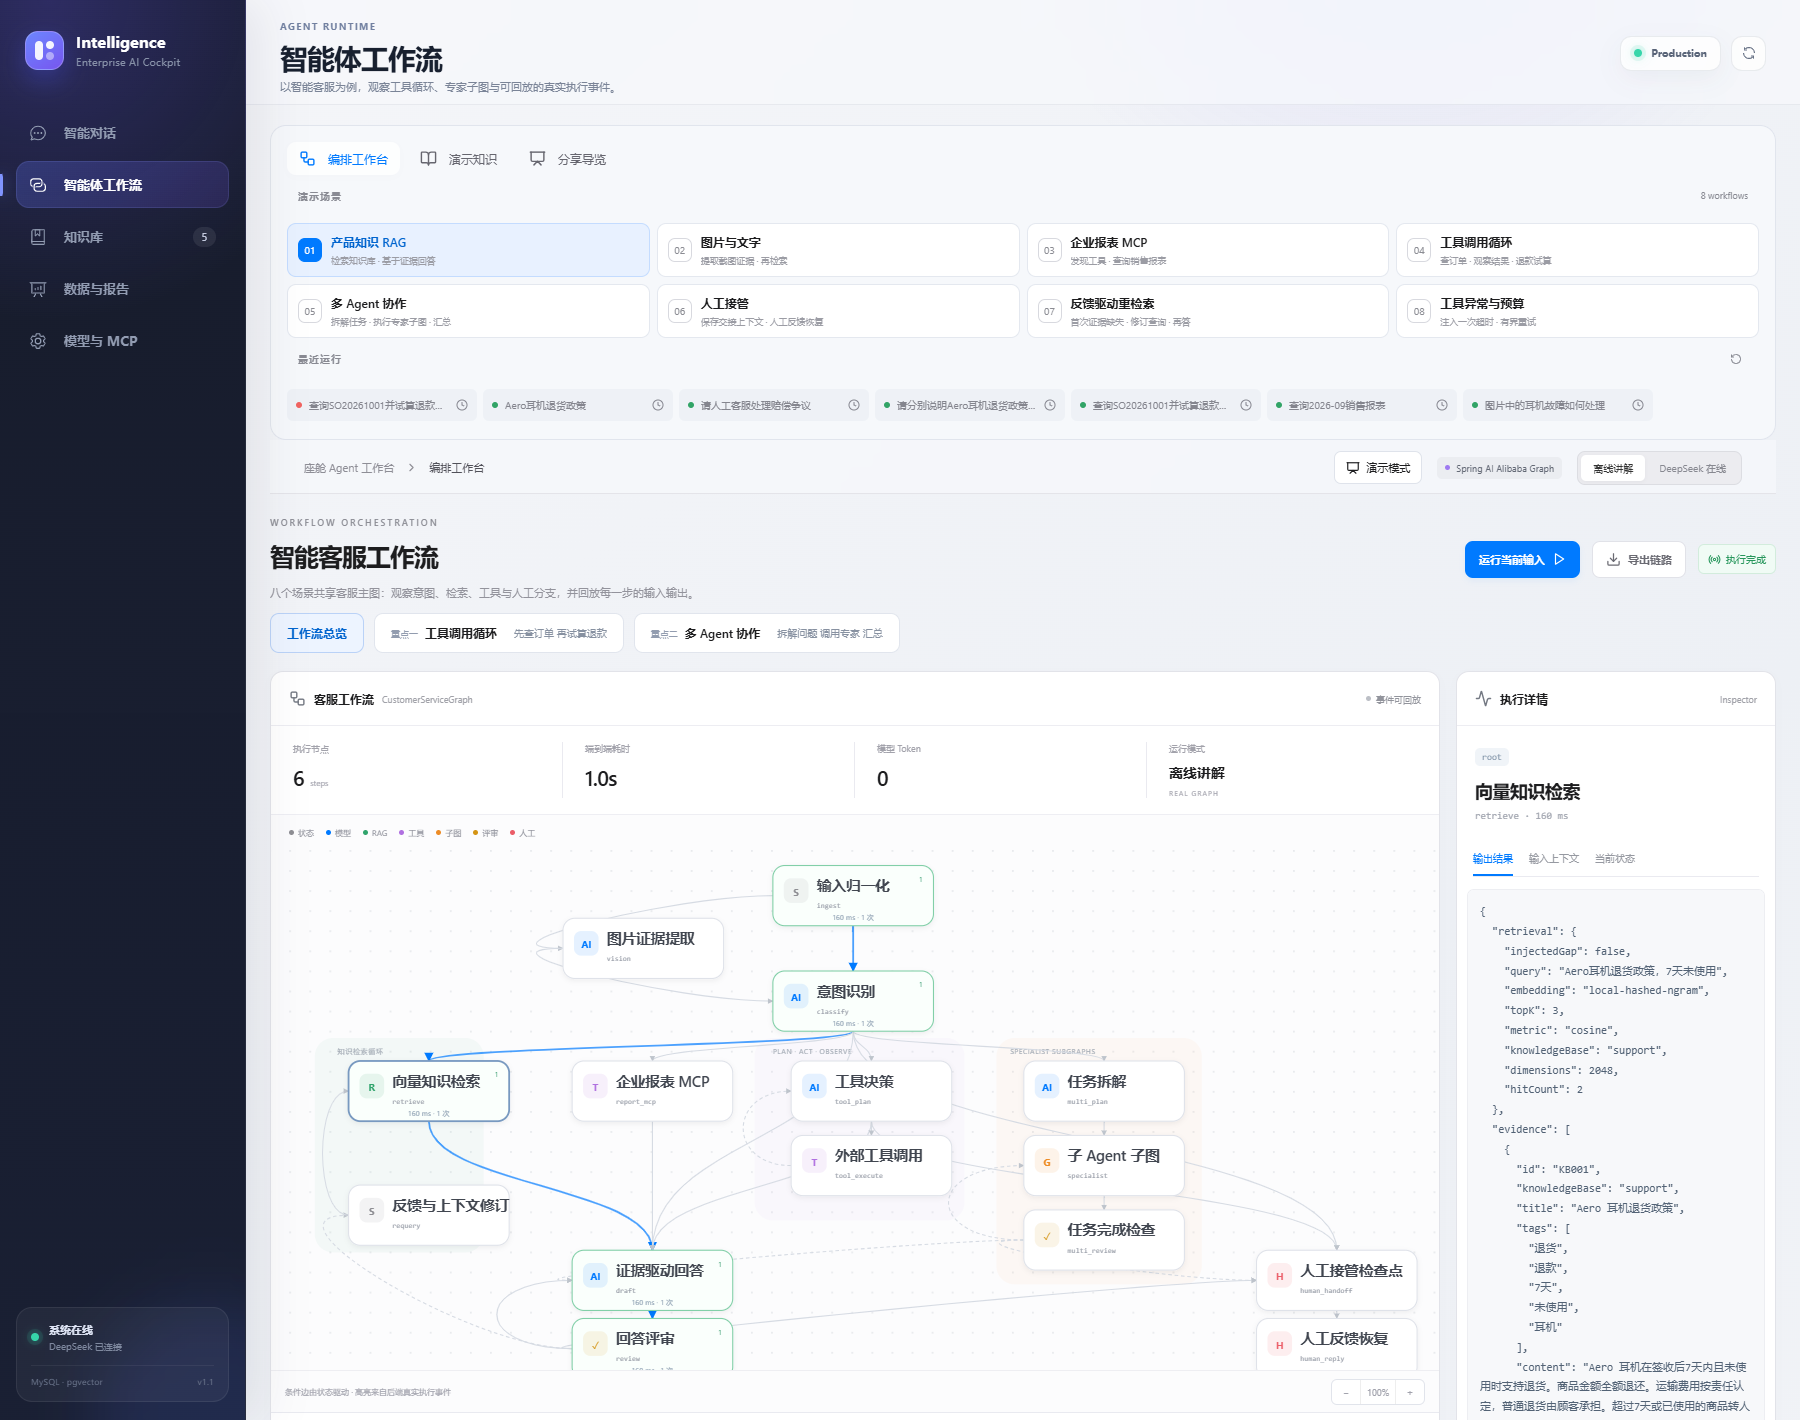
メイングラフは「入力正規化と画像観察 → 意図分類と動的ルーティング(確信度 0.6 未満は人手へ) → ドメイン分岐実行 → 回答生成と根拠レビュー(Draft & Review) → Human-in-the-Loop」の5段階で進む。状態更新には ReplaceStrategy を用い、リスト追記が必要な場合はノード側で既存リストと新結果を結合してから返す。また、モデルが関数名と引数を宣言する Tool Calling と、アプリ側が tools/list・tools/call で外部サービスを統合する MCP を明確に分け、独立稼働するレポート MCP Server も状態マシン管理下のツールとして扱っている。
2つのコア機構のコード実装
ツール呼び出しループ(Tool Loop / ReAct Loop)
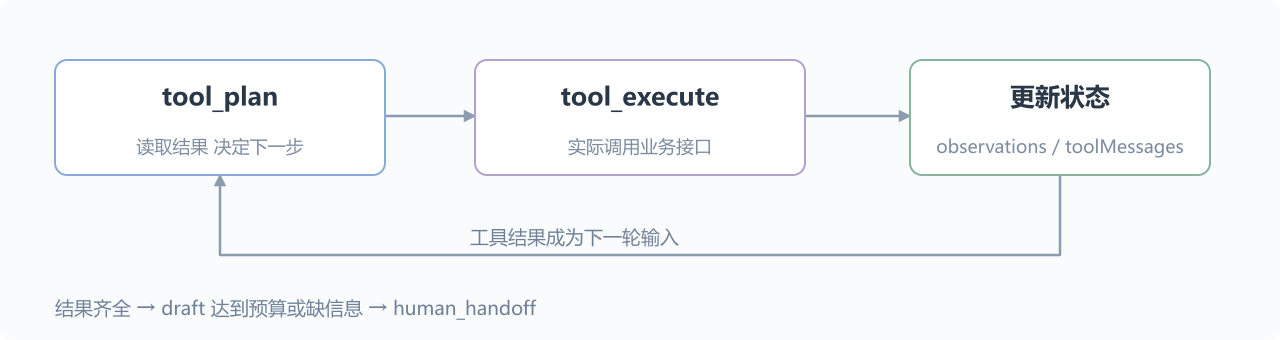
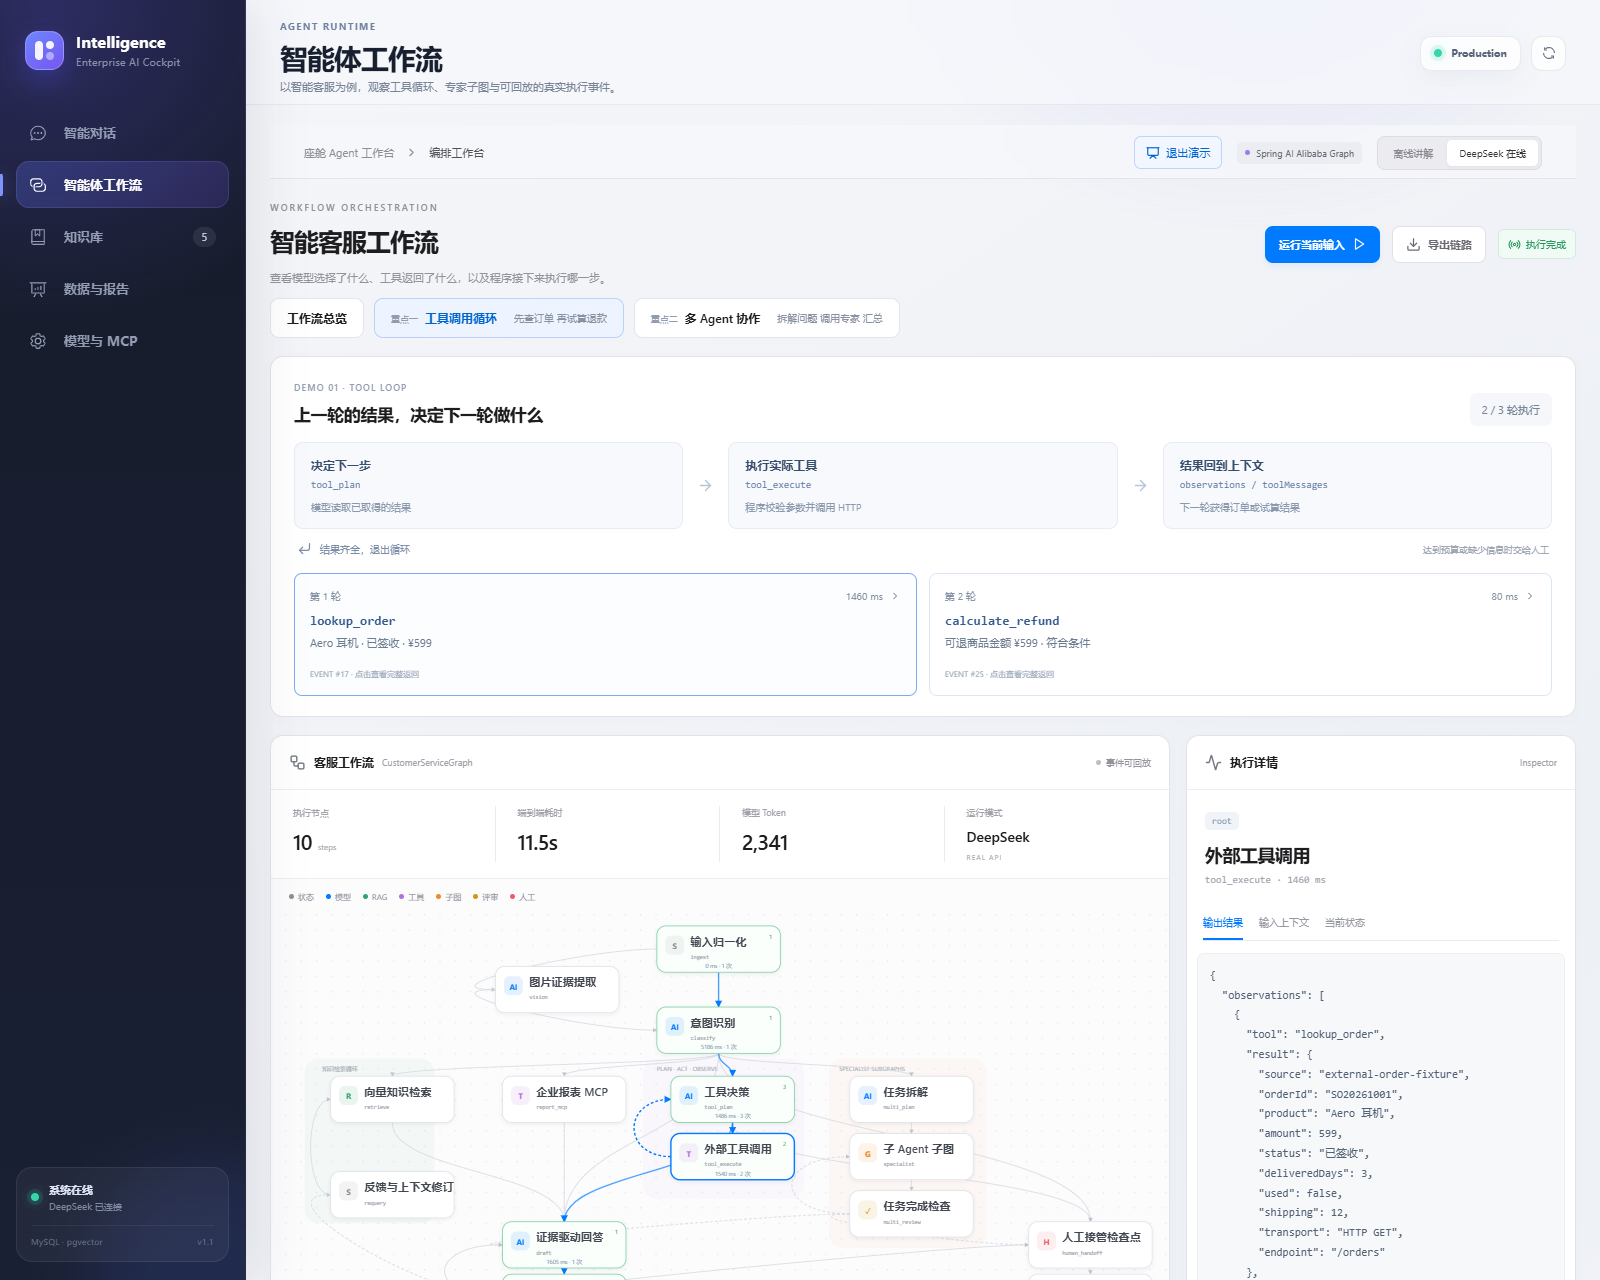
Graph 内では意思決定ノード tool_plan と実行ノード tool_execute に分割している。
graph.addNode("tool_plan", this::toolPlanNode);
graph.addNode("tool_execute", this::toolExecuteNode);

graph.addConditionalEdges(
    "tool_plan",
    edge_async(state -> (String) state.data().get("toolNext")),
    Map.of(
        "execute", "tool_execute",
        "done",    "draft",
        "human",   "human_handoff"
    )
);

graph.addEdge("tool_execute", "tool_plan");

CompiledGraph app = graph.compile(
    CompileConfig.builder().recursionLimit(80).build()
);
ここで重要なのは、モデルが出力する tool_calls はあくまで提案であり、ホストが通信して得たレスポンスこそが実際の Observation であるという点だ。1ラウンド目で lookup_order を実行して「受領3日・未使用・599元」が observations に入り、2ラウンド目で初めて calculate_refund が開放されて返金可能額 599 元が算出される。タイムアウトやラウンド上限到達時も状態マシン側で安全に制御される。
マルチ Agent 協調(Specialist Sub-graphs)
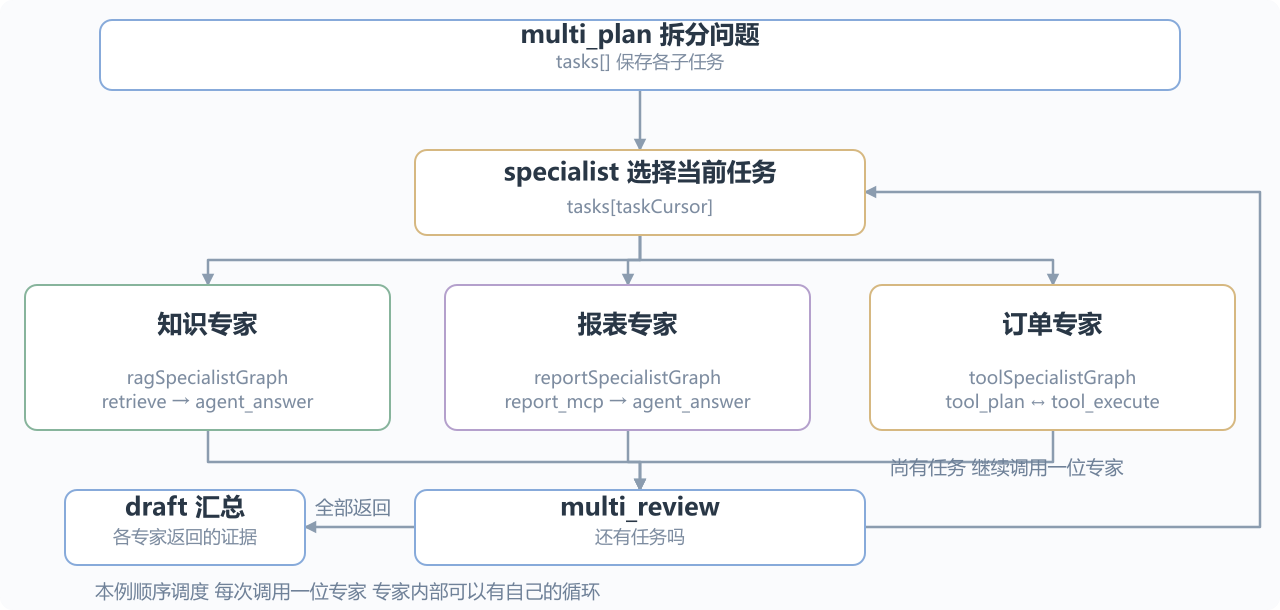
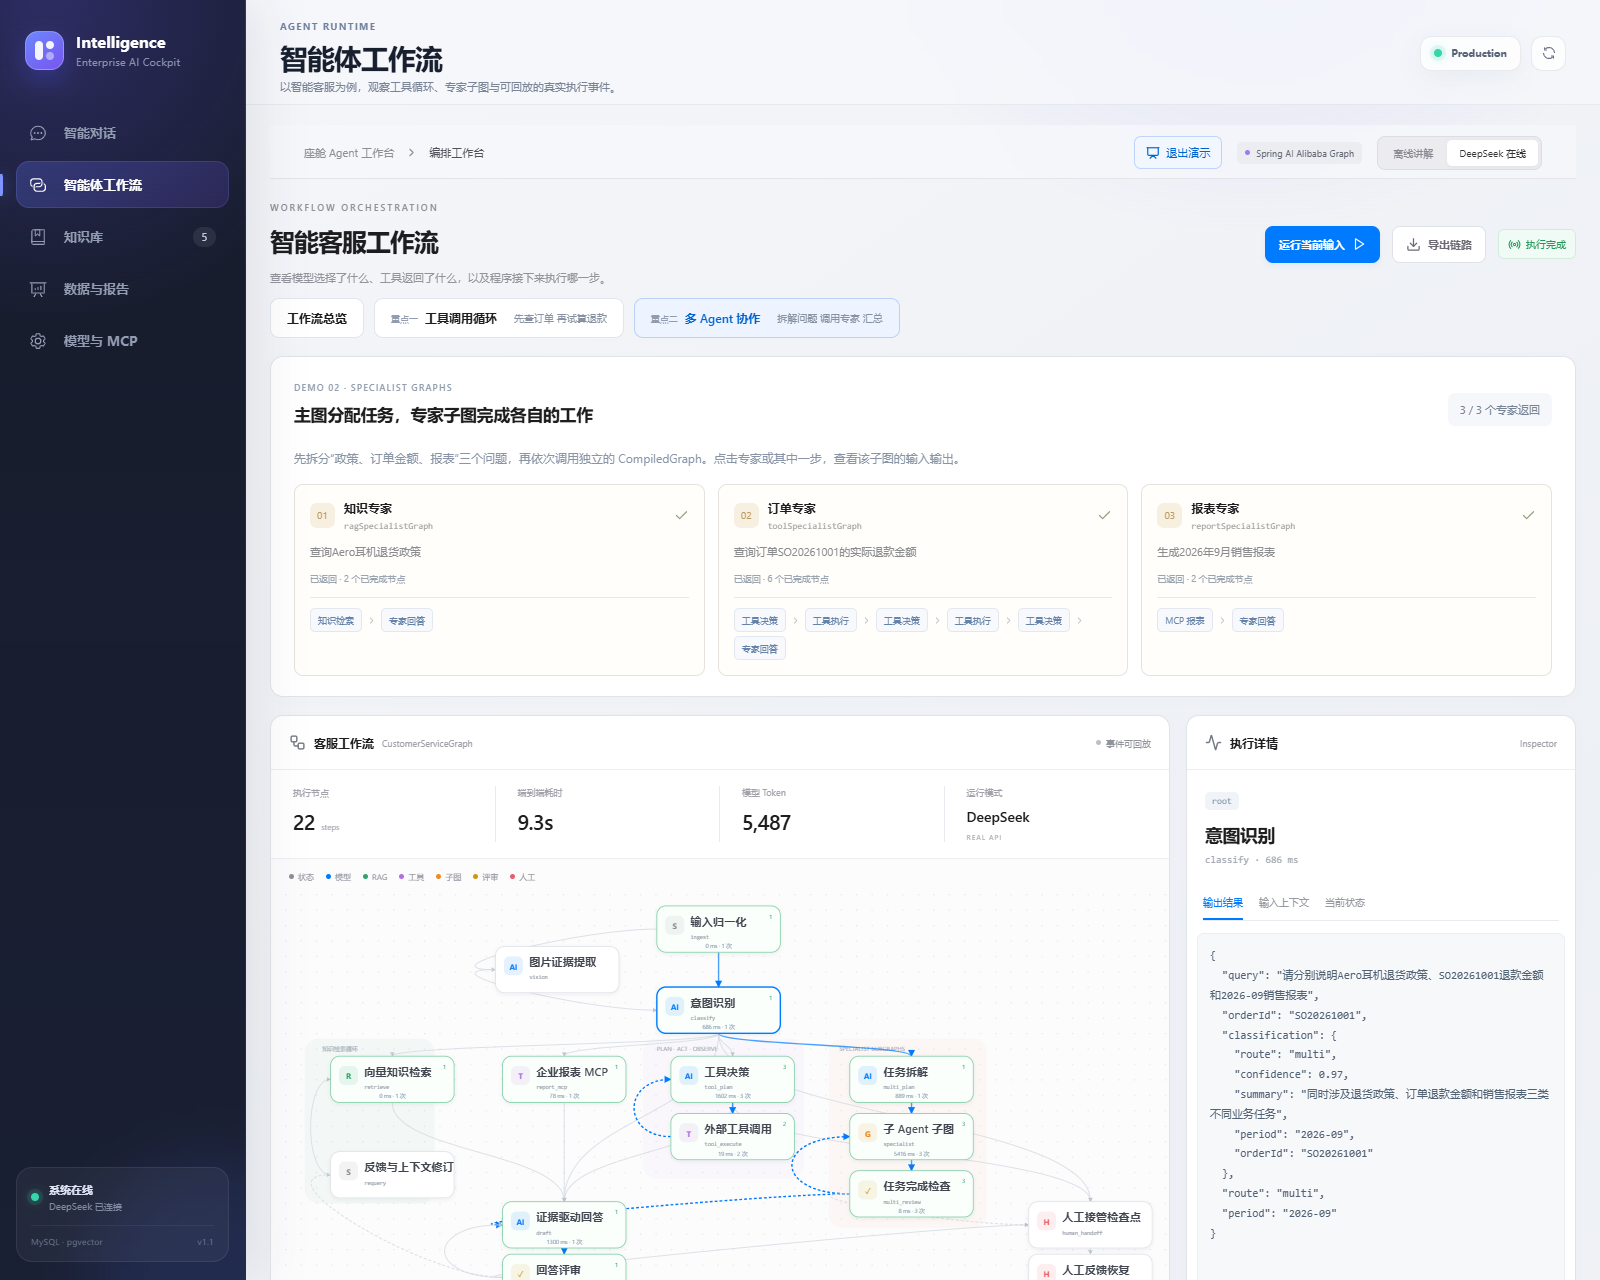
規定・注文返金・9月売上レポートを同時に尋ねられた際、全ツールとスキーマを1つのコンテキストに詰め込むとツール選択の混線が起きやすい。そこでコーディネータが独立した専門家サブグラフを順次呼び出す構成を採った。
graph.addNode("multi_plan", this::decomposeTasksNode);
graph.addNode("specialist", this::invokeSpecialistSubGraphNode);
graph.addNode("multi_review", this::reviewProgressNode);

graph.addEdge("multi_plan", "specialist");
graph.addEdge("specialist", "multi_review");

graph.addConditionalEdges(
    "multi_review",
    edge_async(state -> (String) state.data().get("multiNext")),
    Map.of(
        "next",  "specialist",
        "done",  "draft",
        "human", "human_handoff"
    )
);
multi_plan で複合質問をサブタスク配列へ分解し、specialist が独立した Thread ID で各 CompiledGraph を呼び出しつつ Trace ID と親 Span ID を継承し、multi_review から draft で全根拠を統合する。
カスタマーサービスから Coding Agent とサイバネティクスへ
視点を広げて Claude Code、Cursor、OpenAI Codex、SWE-agent といった Coding Agent を見ると、コードを読み、編集し、バグを直す根底のアーキテクチャはこのワークフローと本質的に同じ構造を持っている。
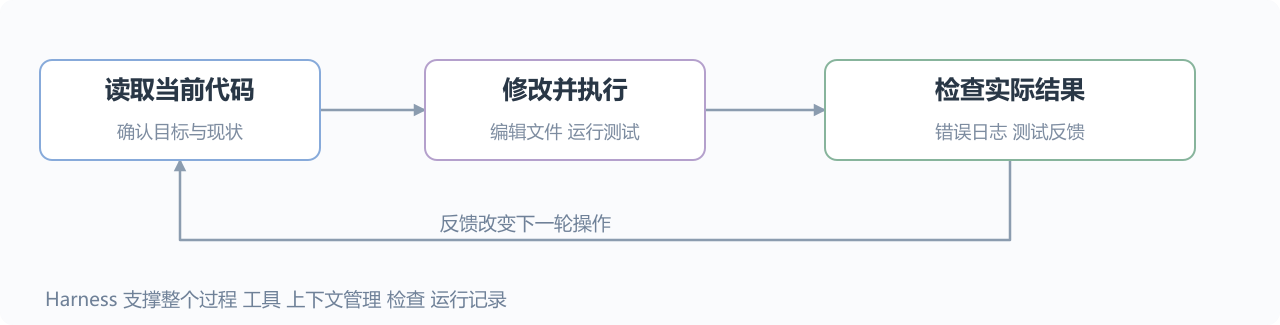
実用的な Coding Agent は「1つのプロンプトからシステム全体を一発生成する」のではなく、高頻度のフィードバックループで動いている。
- 要件解析と目標のすり合わせ(Goal Setting)
- コードベース検索とシンボル特定(Grep / AST ツール)
- 変更方針の立案(Plan)
- ファイルの部分編集(Action)
- コンパイラ・Linter・単体テストの実行(Observe)
- エラー出力の確認:通過すれば終了し、失敗すればエラーを状態へ戻して次の修正を計画(Self-Correction Loop)
Anthropic や OpenAI が Harness Engineering(ハーネス工学) を重視する理由もここにある——“Prompt is cheap, foundation model is commodity, harness is the differentiator”(プロンプトは安価になり、基盤モデルはコモディティ化し、外周のハーネスこそが決定的な差を生む)。
Harness とは、モデルの外側を包むサンドボックス、ツールチェーン、コンテキスト管理、進捗アサーション、評価基盤のことだ。モデルが頭脳なら、Harness はその頭脳に実務の生産性を与えるエンジニアリング上の装具にあたる。
システム科学の視点で見れば、これはノーバート・ウィーナーが20世紀に提唱した**サイバネティクス(Cybernetics / 制御論)**の現代ソフトウェアにおける再現そのものだ。不確実な環境下で自律システムが目標を達成するには、現在の状態と目標状態の誤差(Error)を測定し、その誤差を制御器へ逆入力して次の行動を修正し続ける「負のフィードバック調節」が不可欠であり、それによって初めて誤差が解消されシステムが収束へ向かう。
単発のプロンプト呼び出しは結果が運に左右される開ループ系であり、状態グラフとワークフロー編排を備えた Agent は負のフィードバックを持つ閉ループ系だ。これこそが AI アプリケーションにアーキテクチャ編排を持ち込む本質的な価値だと考えている。
実際の動作はスマートコックピットのワークフローページで8つのシナリオを動かして確認できる。次回はこのワークフローの裏側にあるノード監視とタイムラインリプレイの実装を記録する。